

Provider ohne Umgebungsvariablen konfigurieren
Jede der unten aufgeführten Zugangsdaten (OPENAI_API_KEY, ANTHROPIC_API_KEY, …) kann
stattdessen auf der Seite Providers im Admin-Dashboard (/admin/dashboard) gesetzt werden –
ohne Neustart. So betreiben Sie GoModel am einfachsten ganz ohne Provider-Umgebungsvariablen:
Starten Sie das Gateway ohne konfigurierte Provider (der Katalog ist anfangs leer; das Gateway
startet trotzdem und stellt das Dashboard bereit) und fügen Sie die Provider dann über die UI
hinzu. Ein auf diese Weise hinzugefügter Provider wird sofort im laufenden Gateway registriert.
Provider, die über Umgebungsvariablen oder config.yaml deklariert sind, haben immer Vorrang: Ein
auf eine dieser Arten konfigurierter Name ist im Dashboard schreibgeschützt (angezeigt mit
einem „Config“-Badge) – dieselbe Regel, die GoModel bereits für MCP-Server, virtuelle Modelle und
Rate-Limits anwendet. API-Keys und Service-Account-Secrets werden nach dem Speichern maskiert
(***) – beim Bearbeiten eines Providers wird für alles, was Sie nicht geändert haben, erneut
*** gesendet, und das Gateway behält den gespeicherten Wert. Das Deaktivieren eines Providers
(statt ihn zu löschen) entfernt ihn aus dem Routing, behält aber seine Konfiguration. Die von den
Umgebungsvariablen unterstützte Rotation mehrerer Keys (api_keys, eine geordnete Liste) und der
ausgehende Proxy pro Provider sind ebenfalls im Dashboard-Formular
verfügbar.
Unterstützte Provider
Die Beispiel-Modellbezeichner dienen der Veranschaulichung und können sich ändern; aktuelle Modelle finden Sie in den Katalogen der Provider. Die Feature-Spalten geben die API-Unterstützung des Gateways wieder, nicht jede einzelne Modellfähigkeit, die ein Upstream-Provider anbietet.
✅ Unterstützt ❌ Nicht unterstützt
Hinweise zu den Providern
- OpenAI-Reasoning-Modelle – bei Modellen der o-Serie sowie GPT-5 und neuer (einschließlich
GPT-6) sendet GoModel
max_tokensalsmax_completion_tokensund verwirfttemperatureundtop_p, sofernreasoning_effortnicht"none"ist (der einzige Fall, in dem diese Modelle sie akzeptieren). OpenAI lehntstopfür diese Modelle ab, daher schneidet GoModel die Ausgabe selbst bei der ersten Stoppsequenz ab und meldet sie instop_sequence. Einreasoning_effort, den das Modell nicht akzeptiert, wird auf die nächstgelegene akzeptierte Stufe verschoben (zum Beispiel wirdminimalab GPT-5.1 zulowundmaxzuxhigh). Ab GPT-5.6 akzeptiert OpenAI Function-Tools in Chat Completions nur mitreasoning_effort: "none", daher erhält ein Tool-Request ohne gesetzten Effort den Wert"none". - OpenAI-Requests, die über Responses bedient werden – manche Chat-Requests (Chat Completions
und
/v1/messages) können von OpenAIs Chat Completions nicht bedient werden: Function-Tools mit Reasoning-Effort ab GPT-5.6, jeder Tool Call bei GPT-6 Astra und GPT-6.1 (sie lehnen"none"ab), Tool-Ergebnisse mit Bildern oder Dateien (Chat Completions akzeptiert sie, aber das Modell sieht sie nie) sowie per URL übergebene Dateien. GoModel sendet diese mitstore: falsean OpenAIs/v1/responsesund gibt eine normale Chat Completion bzw. einen normalen Chunk-Stream zurück. Ein Request mit einem Feld, für das die Responses API keine Entsprechung hat (zum Beispielnoderlogprobs), bleibt bei Chat Completions. - llm-d – richten Sie
LLMD_BASE_URLauf den Router/EPP-Service aus und deklarieren SieLLMD_MODELS, wenn die Route/v1/modelsnicht bedient. Der dedizierte Provider fügt vertrauenswürdige Header für Inference-Objective und User-Path-Fairness ein. - Z.ai GLM Coding Plan – setzen Sie
ZAI_BASE_URL=https://api.z.ai/api/coding/paas/v4. - Z.ai-Reasoning-Effort –
reasoning.effort(Chat Completions und Responses) wird alsreasoning_effortauf oberster Ebene an Z.ai gesendet. GLM-5.3 und GLM-5.3-Flash denken immer und akzeptieren nurlow,highundmax, daher werdennoneundminimalauflow,mediumaufhighundxhighaufmaxabgebildet. Andere GLM-Modelle erhalten die Stufe unverändert. - Groq-Reasoning und Transkriptionen – bei den Familien gpt-oss und qwen3 setzt GoModel Groqs
reasoning_formatstandardmäßig aufparsed, sodass die Chain of Thought inreasoningankommt statt als Inline-Text<think>…</think>innerhalb der Antwort. Senden Siereasoning_formatselbst (rawoderhidden), um dies zu überschreiben. Bei JSON-Responses für Transkription und Übersetzung wird Groqs herstellerspezifisches Feldx_groqentfernt, damit sie dem OpenAI-Format entsprechen. - MiniMax-Regionen und aktuelle Textmodelle – der standardmäßige globale Endpunkt ist
https://api.minimax.io/v1; Konten auf der China-Plattform solltenMINIMAX_BASE_URL=https://api.minimaxi.com/v1setzen. Die aktuellen Textmodell-IDs sindMiniMax-M3(Kontext von 1.000.000 Token; Text-, Bild- und Video-Input) undMiniMax-M2.7(Kontext von 204.800 Token; Text-Input). Die Preise pro Million Token in USD betragen für M3 $0.60 Input, $2.40 Output und $0.12 gecachten Input sowie für M2.7 $0.30 Input, $1.20 Output, $0.06 gecachten Input und $0.375 für Cache-Writes. M3 unterstützt adaptives oder deaktiviertes Thinking; M2.7 denkt immer. - Amazon Bedrock Mantle – GPT-5.6 Sol, Terra und Luna akzeptieren auf Mantle nur die Responses
API. GoModel sendet
/v1/responses-Requests direkt an AWS und wählt den erforderlichen Upstream-Pfad/openai/v1/responses. - Fireworks AI – Modell-IDs sind kontobezogene Pfade wie
accounts/fireworks/models/gpt-oss-120b; verwenden Sie sie unverändert in Requests und inFIREWORKS_MODELS. - ElevenLabs – ein reiner Sprach-Provider:
/v1/audio/speech(Text-to-Speech) und/v1/audio/transcriptions(Speech-to-Text) werden unterstützt, Chat,/v1/responsesund Embeddings dagegen nicht (die ❌ oben spiegeln das wider, keine Einschränkung des Gateways). Das OpenAI-Feldvoicemuss eine ElevenLabs-voice_id sein. Unterstützte Audioformate und Speech-to-Text-Modelle finden Sie im ElevenLabs-Leitfaden. - Chutes AI – verwendet standardmäßig
https://llm.chutes.ai/v1und ermittelt aktuelle Modell-IDs, Kontextlimits, Capabilities und Preise aus dem Live-Katalog. GoModel übersetzt/v1/responses-Requests in Chat Completions; der gemeinsame LLM-Endpunkt von Chutes stellt keine Embeddings bereit. Die Passthrough-Unterstützung erfordert ein ausdrückliches Opt-in des Betreibers, indemchuteszuENABLED_PASSTHROUGH_PROVIDERShinzugefügt wird. - Meta (Muse Spark) – die Meta Model API ist OpenAI-kompatibel; setzen Sie
META_API_KEYund routen Sie zumuse-spark-1.1. Muse-Spark-Modelle sind noch nicht im Upstream-Modellkatalog enthalten. Deklarieren Sie dahercontext_windowundpricingin den Metadaten unterproviders.meta.modelsinconfig.yaml, wenn Sie Kostenerfassung und Angaben zum Kontextfenster wünschen. - Kilo AI – Modell-IDs haben die Form
provider/model(zum Beispielanthropic/claude-sonnet-4.5) und werden unverändert weitergeleitet. GoModel bedient/v1/responses, indem es den Request in Kilos Chat-Completions-Endpunkt übersetzt. Stellt ein anderer konfigurierter Provider dieselbe rohe Modell-ID bereit, wählen Sie Kilo explizit mitkilo/anthropic/claude-sonnet-4.5; GoModel entfernt vor dem Weiterleiten nur den äußeren Routing-Qualifierkilo/. - Eden AI – Modell-IDs haben die Form
provider/model(zum Beispielopenai/gpt-4) und werden unverändert weitergeleitet; wählen Sie Eden explizit mitedenai/openai/gpt-4, wenn ein anderer konfigurierter Provider dieselbe rohe ID bereitstellt. GoModel ermittelt Edens Katalog, Kontextfenster, Capabilities und Preise pro Token über Edens eigenes/v3/models, daher gibt es keine eingebaute Modellliste, und neue Eden-Modelle erfordern kein Upgrade. Die Kosten pro Request stammen aus dem exakten USD-Wertcost, den Eden bei jeder Response zurückgibt, und nicht aus einer Token-Berechnung. GoModel bedient/v1/responses, indem es den Request in Edens Chat-Completions-Endpunkt übersetzt – Edens eigenes/v3/responsesist eine andere API und wird nie verwendet. Siehe den Eden-AI-Leitfaden. - Xiaomi MiMo – TTS (
mimo-v2.5-tts*) und ASR (mimo-v2.5-asr) werden über/v1/audio/speechund/v1/audio/transcriptions(übersetzt in MiMos Audio-Dialekt für Chat Completions) sowie direkt über Chat Completions bedient; für einen Kontext von 1M hängen Sie[1m]an die Modell-ID an und führen sie inXIAOMI_MODELSauf. - OpenCode Go (OpenCode Zen) – routet pro Modell: Die meisten Modelle verwenden
/chat/completionsim OpenAI-Stil, während reine/messages-Modelle (standardmäßigqwen3.7-max, überschreibbar mitOPENCODE_GO_MESSAGES_MODELS) an den Anthropic-nativen Endpunkt gesendet werden. Chat-Requests ohne Reasoning-Parameter erhaltenreasoning_effort: "low", weil manche Modelle immer denken und Requests ablehnen, in denen er fehlt (überschreibbar mitOPENCODE_GO_DEFAULT_REASONING_EFFORT). Setzen SieOPENCODE_GO_API_KEY; die Base-URL ist standardmäßighttps://opencode.ai/zen/go/v1. - ChatGPT-Abonnement – bedient nur
/v1/responsesund wird über das Kontingent des ChatGPT-Plans abgerechnet statt über API-Guthaben. Der Upstream akzeptiert nur eine strikte Allowlist von Parametern und ausschließlich Streaming; GoModel passt Requests an und fasst den Stream für Aufrufer ohne Streaming zusammen. Setzen SieCHATGPT_API_KEYauf das Access-Token auscodex login. Die gemeldeten Kosten sind keine tatsächlichen Ausgaben: Diese Modell-IDs gibt es auch auf der OpenAI Platform, daher ordnet die Registry dem pauschal abgerechneten Abonnement-Traffic ihre Preise pro Token zu – halten Sie Budgets undcost-Load-Balancing davon fern. - Kimi Code – keine Preise pro Token; das Kontingent wird wöchentlich erneuert und ist zusätzlich
durch ein rollierendes 5-Stunden-Fenster begrenzt. Die Kostenerfassung meldet für Kimi Code null,
daher kann
cost-Load-Balancing es nicht bepreisen; bevorzugen Sie konservative Retry-Strategien. - Hetzner (experimentell) – Hetzner bezeichnet die Inferenz-API als experimentell: Rechnen Sie
mit Breaking Changes und ohne SLA. Der Modellkatalog und die Rate-Limit-Fenster ändern sich,
solange das Experiment läuft; fragen Sie den Live-Endpunkt
/v1/modelsund die offizielle Dokumentation ab, statt sich auf Momentaufnahmen zu verlassen. Die Beispiel-Modell-ID in der Tabelle oben (Qwen/Qwen3.6-35B-A3B-FP8) ist der Eintrag aus der offiziellen Hetzner-Dokumentation mit Stand 2026-08-17 und kann zum Zeitpunkt des Lesens abweichen. Während der experimentellen Phase kostenlos, daher meldet die Kostenerfassung null, undcost-Load-Balancing kann es nicht bepreisen. Kein Embeddings-Endpunkt; nur Chat,/v1/responses(über Chat), Modellauflistung und Passthrough. Passthrough ist eine generische Weiterleitung – das ✅ kennzeichnet die Fähigkeit des Adapters; ob Hetzner beliebige Upstream-Pfade toleriert, ist nicht verifiziert, solange die API experimentell ist.hetznerist in der standardmäßigen AllowlistENABLED_PASSTHROUGH_PROVIDERSenthalten, sodass/p/hetzner/...-Routen ohne Opt-in des Betreibers funktionieren; entfernen Sie es aus der Liste, um sie zu sperren. - Konfigurierte Modelllisten – für jeden Provider über
<PROVIDER>_MODELSverfügbar, zum BeispielOPENROUTER_MODELS=openai/gpt-oss-120b,anthropic/claude-sonnet-4oderORACLE_MODELS=openai.gpt-oss-120b,xai.grok-3. DeepSeek verwendet standardmäßighttps://api.deepseek.com; setzen SieDEEPSEEK_BASE_URLnur, wenn Sie einen kompatiblen Proxy oder einen alternativen DeepSeek-Endpunkt verwenden. Standardmäßig verwendetCONFIGURED_PROVIDER_MODELS_MODE=fallbackdiese Listen nur, wenn das Upstream-/modelsnicht verfügbar oder leer ist. Setzen SieCONFIGURED_PROVIDER_MODELS_MODE=allowlist, um für Provider mit einer definierten Liste nur die konfigurierten Modelle bereitzustellen und deren Upstream-Aufrufe von/modelszu überspringen. - Modellfilter – grenzen Sie einen großen Katalog per Glob-Muster oder Preis ein, statt Modelle
einzeln aufzulisten:
OPENROUTER_MODEL_FILTER_INCLUDE=*:freebehält nur die kostenlose Stufe von OpenRouter, und<PROVIDER>_MODEL_FILTER_MAX_PRICE_PER_MTOKbegrenzt, wohin ein Provider routen darf. Siehe Modelle eines Providers filtern. - Modellkategorien (Chat vs. Embeddings vs. Audio) – die Kategorie eines Modells ergibt sich aus
seinen
modes, die aus vier Quellen in absteigender Priorität ermittelt werden: der entfernten Modell-Registry, Betreiber-Metadaten, die unterproviders.<name>.modelsinconfig.yamldeklariert sind (z. B.modes: [embedding]), Capability-Signalen in der eigenen Modellauflistung des Providers (GeminisupportedGenerationMethods, Cohereendpoints, OpenRouter-Modalitäten der Architektur, Ollama-Capabilities aus/api/show) und schließlich einer konservativen Namensprüfung für noch unklassifizierte Modelle: IDs, dieembedenthalten oder bekannten Embedding-Familien entsprechen (bge,e5,gte,minilm), werden als Embedding-Modelle eingeordnet, und IDs, diererankenthalten, als Reranking-Modelle – bei IDs mit Namespace wieorg/modelwird das letzte Pfadsegment geprüft. Deklarieren Sie Betreiber-Metadaten nur, wenn ein Modell nach alledem unklassifiziert bleibt. Kategorien wirken sich nur auf die Gruppierung im Dashboard aus;/v1/embeddingsroutet unabhängig von der Kategorie zu jedem Modell, das der Provider bereitstellt. - vLLM – setzen Sie
VLLM_API_KEYnur, wenn der Upstream-Server mit--api-keygestartet wurde. - audio.cpp –
AUDIOCPP_BASE_URList erforderlich (der Standardport von audiocpp_server kollidiert mit GoModels eigenem Port 8080, daher gibt es keinen Standardwert);AUDIOCPP_API_KEYbleibt meist ungesetzt, da audio.cpp keine eigene Authentifizierung hat. Nur Audio:/v1/audio/speechund/v1/audio/transcriptionswerden dorthin geroutet, und seine Routen für Details, Alignment und Live-Streaming sind über Passthrough erreichbar. Siehe audio.cpp. - Jev / Kev – die System One API von TypeSafe ist eine Decision-API (Zustand und typisierte
Fragen hinein, kalibrierte Wahrscheinlichkeiten heraus). GoModel leitet sie nativ und
unübersetzt unter
POST /v1/systemoneweiter (mit virtuellen Modellen, Guardrails, Audit und Nutzung) sowie über Passthrough unter/p/jev/..., und beantwortet damit OpenAIs Decisions API unterPOST /v1/decisions, indem es in beide Richtungen übersetzt./v1/decisionsist verfügbar, sobald einopenai-,jev- oderopenrouter-Provider konfiguriert ist, und/v1/systemone, sobald einjev- oderopenrouter-Provider konfiguriert ist; OpenRouter bedient Jev nativ, und seine Decision-Modelle werden als Utility-Modelle aufgeführt.JEV_API_KEYkonfiguriert die gehostete API; für einen selbst gehosteten Kev-Server, der dieselbe API ohne Authentifizierung spricht, setzen SieJEV_BASE_URLund lassen den Key ungesetzt. Siehe Jev. - llama.cpp / LM Studio –
LLAMACPP_BASE_URList erforderlich (der Standardport von llama-server kollidiert mit GoModels eigenem Port 8080, daher gibt es keinen Standardwert);LLAMACPP_API_KEYist optional. Registrieren Sie diese Server nicht alsollama, da dieser Typ die native API von Ollama spricht. Siehe llama.cpp. - llm-d –
LLMD_BASE_URList erforderlich.LLMD_API_KEYist optional und wird nur gesendet, wenn das Gateway vor dem Router Bearer-Authentifizierung verlangt. - SGLang – setzen Sie
SGLANG_API_KEYnur, wenn der Upstream-Server mit--api-keygestartet wurde; andernfalls genügtSGLANG_BASE_URL. - Mehrere API-Keys für einen Provider – setzen Sie
OPENAI_API_KEY_2,OPENAI_API_KEY_3usw., um Sessions auf mehrere Keys zu verteilen, wobei jede Konversation für die Prompt-Cache-Affinität bei einem Key bleibt. Siehe API-Key-Rotation. - Mehrere Instanzen eines Provider-Typs – verwenden Sie ohne
config.yamlUmgebungsvariablen mit Suffix wieOPENAI_EAST_API_KEYundOPENAI_EAST_BASE_URL; fügen SieOPENAI_EAST_MODELShinzu, um die Modellliste dieser Instanz zu konfigurieren. Damit wird der Provideropenai-eastmit dem Typopenairegistriert. Vertex AI folgt demselben Suffix-Muster –VERTEX_US_PROJECTregistriert den Providervertex-us. Die Umgebungsvariablen für Vertex-Projekt und -Standort müssen zum Präfix der Instanz passen: Setzen Sie für eine Instanz mit Suffix wieVERTEX_US_PROJECTauchVERTEX_US_LOCATIONund alle weiteren Einstellungen mit Suffix für diese Instanz, statt der generischenVERTEX_PROJECT/VERTEX_LOCATION.VERTEX_AUTH_TYPEverwendet standardmäßig Application Default Credentials (gcp_adc).
Was GoModel in Responses normalisiert
GoModel gibt pro Feld eine einheitliche Form zurück, unabhängig davon, welcher Provider geantwortet hat, und leitet alles andere genau so weiter, wie der Provider es gesendet hat.- Reasoning-Text kommt als
reasoning_contentzurück, inchoices[].messageund in gestreamtenchoices[].delta. Groq liefert ihn alsreasoning; GoModel benennt ihn um, sodass derselbe Client-Code die Chain of Thought von Groq, DeepSeek, Anthropic, Cohere und vLLM gleichermaßen liest. - Herstellerspezifische Felder werden nicht entfernt. Groqs
x_groqund seine Nutzungs-Timingsqueue_time/prompt_time/completion_timesowie DeepSeeksprompt_cache_hit_tokens/prompt_cache_miss_tokenserreichen den Client unverändert – über diese Durchreichung erhalten Sie Provider-eigene Extras, ohne auf ein GoModel-Release zu warten. Lesen Sie Cache-Treffer aus dem portablenusage.prompt_tokens_details.cached_tokens, wenn Sie Provider-unabhängigen Code wünschen. Siehe ADR-0011. - Streams enthalten ein abschließendes
usage, auch wenn Sie es nicht angefordert haben. Bei aktivierter Nutzungserfassung fügt GoModel jedem Streaming-Requeststream_options.include_usagehinzu, um den Aufruf bepreisen zu können, und der Usage-Chunk des Providers wird unverändert weitergereicht; OpenAIs eigene API lässt die Nutzung weg, sofern der Client sie nicht anfordert. Die meisten Provider senden sie als separaten abschließenden Chunk mit leeremchoices-Array, DeepSeek hängt sie an seinen letzten Content-Chunk an. Ignorieren Sie das Feld, oder setzen SieENFORCE_RETURNING_USAGE_DATA=false, damit GoModel es nicht mehr anfordert – auf Kosten von Nutzungsdatensätzen für gestreamte Requests bei Providern, die die Nutzung nur auf Anforderung melden.
Warum manche Provider eigene Seiten haben
Bei diesen Providern stoßen die meisten Benutzer auf Schwierigkeiten:- Google Vertex AI – benötigt ein GCP-Projekt, eine Region und entweder Application Default Credentials oder einen JSON-Key eines Service-Accounts.
- Amazon Bedrock – kein eigener API-Key; verwendet die AWS-Credential-Chain und erfordert einen expliziten Modellzugriff in der Bedrock-Konsole.
- Azure OpenAI – Deployment-bezogene Base-URLs, der Query-Parameter
api-versionund der Headerapi-keystattAuthorization: Bearer. - Oracle GenAI – erfordert eine OCI-IAM-Richtlinie für
generativeaiapikeyund eine regionsspezifische OpenAI-kompatible Endpunkt-URL. - Google Gemini (AI Studio) – zwei Routing-Modi (natives
generateContentvs. OpenAI-kompatibel) mit unterschiedlichem Verhalten beim Bild-Input. - Anthropic – der Reasoning-Effort wird auf Claudes Adaptive Thinking und Effort-Steuerung abgebildet, die sich zwischen Modellgenerationen unterscheiden.
- DeepSeek – Besonderheiten bei der Zuordnung des Reasoning-Efforts für DeepSeek V4.
- Ollama / SGLang / vLLM – Hosting lokaler Modelle mit optionaler Einrichtung mehrerer Instanzen über Umgebungsvariablen mit Suffix und Provider-qualifizierte Modell-IDs.
- Xiaomi MiMo – standardmäßig aktivierter Thinking-Modus, ein Kontext-Suffix
[1m]sowie TTS/ASR, die über Chat Completions statt über native Audio-Endpunkte laufen. - OpenCode Go – OpenCode Zen verteilt Modelle auf
/chat/completionsim OpenAI-Stil und Anthropic-natives/messages; GoModel routet pro Modell (die Menge der reinen/messages-Modelle wird manuell gepflegt, Standardqwen3.7-max). - ChatGPT-Abonnement – ein reiner Responses-Upstream mit einer strikten Parameter-Allowlist, der genutzt wird, um GoModel zwischen Codex und einen ChatGPT-Plan zu setzen.
Provider-Status
Das Admin-Dashboard (/admin/dashboard) zeigt den Live-Status jedes konfigurierten Providers im
Abschnitt Providers Overview der Seite Overview.
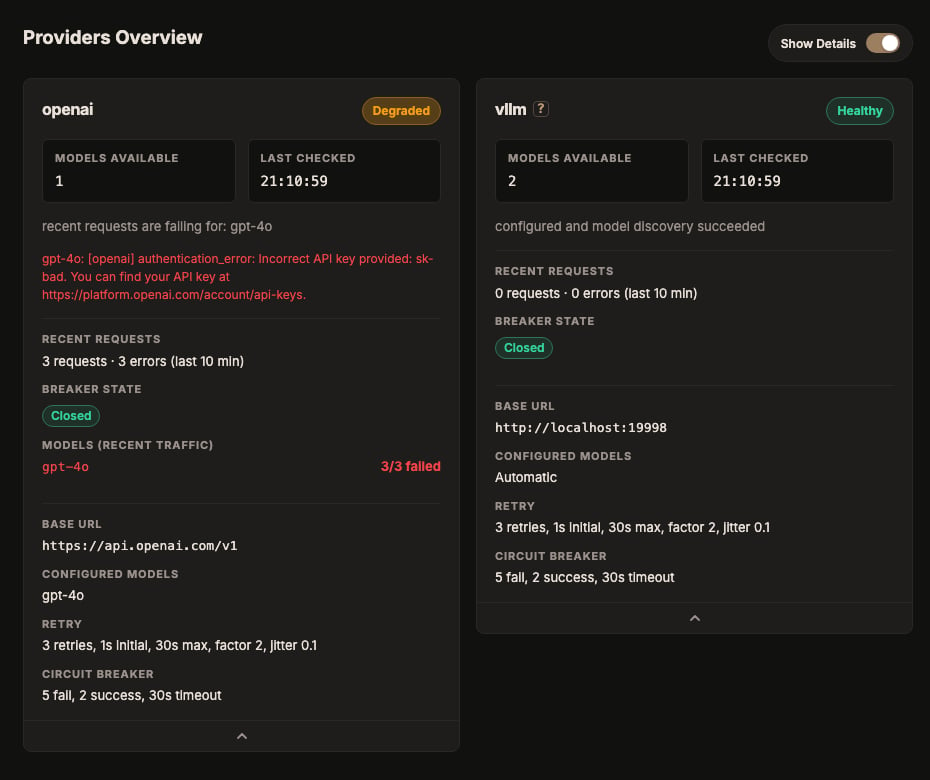
Klappen Sie eine Karte auf (über den Pfeilstreifen unten oder den abschnittsweiten Schalter
Show Details), um Details zum Request-Zustand zu sehen:
- Recent Requests – Requests und Fehler über das Gateway in den letzten 10 Minuten.
- Breaker State – der aktuelle Zustand des Circuit Breakers des Providers (siehe Ausfallsicherheit).
- Models (Recent Traffic) – Anzahl der Requests/Fehler pro Modell. Ein Modell mit mindestens
3 Fehlern, die die Hälfte oder mehr seiner Requests im Zeitfenster ausmachen, wird rot markiert –
so wird ein einzelnes defektes Modell bei einem ansonsten gesunden Provider erkannt, was die
Modellerkennung allein nicht sehen kann. Fahren Sie mit der Maus über eine Zeile, um die letzte
Fehlermeldung des Modells zu sehen. Eine
200-Response ohne Choices, ohne Output oder ohne Token-Nutzung zählt hier ebenfalls als Fehler.
GET /admin/providers/status verfügbar.