

Konfiguracja providerów bez zmiennych środowiskowych
Każde z poniższych danych uwierzytelniających (OPENAI_API_KEY, ANTHROPIC_API_KEY, …)
możesz zamiast tego ustawić na stronie Providers w dashboardzie
administracyjnym (/admin/dashboard) – bez restartu. To najprostszy sposób na
uruchomienie GoModel bez żadnych zmiennych środowiskowych providerów: uruchom
gateway bez skonfigurowanych providerów (katalog startuje pusty; gateway i tak
się uruchamia i serwuje dashboard), a następnie dodaj providerów z UI. Provider
dodany w ten sposób od razu rejestruje się w działającym gatewayu.
Providerzy zadeklarowani przez zmienne środowiskowe lub config.yaml zawsze mają
pierwszeństwo: nazwa skonfigurowana w którykolwiek z tych sposobów jest w
dashboardzie tylko do odczytu (oznaczona plakietką „Config”) – to ta sama
zasada, którą GoModel stosuje już do serwerów MCP, modeli wirtualnych i limitów
żądań. Klucze API i sekrety kont serwisowych są po zapisaniu maskowane (***) –
edycja providera wysyła ponownie *** dla wszystkiego, czego nie zmieniłeś, a
gateway zachowuje zapisaną wartość. Wyłączenie providera (zamiast usunięcia)
wyrejestrowuje go z routingu, ale zachowuje jego konfigurację. W formularzu
dashboardu dostępna jest ta sama rotacja wielu kluczy, którą obsługują zmienne
środowiskowe (api_keys, uporządkowana lista), oraz
proxy wychodzące per provider.
Obsługiwani providerzy
Przykładowe identyfikatory modeli są poglądowe i mogą się zmienić; aktualne modele sprawdzaj w katalogach providerów. Kolumny funkcji odzwierciedlają obsługę API w gatewayu, a nie każdą możliwość poszczególnych modeli udostępnianą przez providera upstream.
✅ Obsługiwane ❌ Nieobsługiwane
Uwagi dotyczące providerów
- Modele reasoningowe OpenAI – dla modeli z serii o oraz GPT-5 i nowszych
(w tym GPT-6) GoModel wysyła
max_tokensjakomax_completion_tokensi pomijatemperatureoraztop_p, chyba żereasoning_effortma wartość"none"(jedyny przypadek, w którym te modele je akceptują). OpenAI odrzucastopdla tych modeli, więc GoModel sam obcina wynik na pierwszej sekwencji stop i raportuje ją wstop_sequence.reasoning_effort, którego model nie akceptuje, jest zamieniany na najbliższy obsługiwany poziom (na przykładminimalstaje sięlowod GPT-5.1, amaxstaje sięxhigh). Od GPT-5.6 OpenAI akceptuje function tools w Chat Completions tylko zreasoning_effort: "none", więc request z narzędziami bez ustawionego effort dostaje"none". - Requesty OpenAI obsługiwane przez Responses – niektórych requestów chat
(Chat Completions i
/v1/messages) nie da się obsłużyć przez Chat Completions OpenAI: function tools z reasoning effort w GPT-5.6+, dowolne wywołanie narzędzia w GPT-6 Astra i GPT-6.1 (odrzucają"none"), wyniki narzędzi z obrazami lub plikami (Chat Completions je akceptuje, ale model nigdy ich nie widzi) oraz pliki podane przez URL. GoModel wysyła je do/v1/responsesOpenAI zstore: falsei zwraca zwykłe chat completion lub stream chunków. Request z polem, które nie ma odpowiednika w Responses API (na przykładnlublogprobs), pozostaje w Chat Completions. - llm-d – skieruj
LLMD_BASE_URLna usługę Router/EPP i zadeklarujLLMD_MODELS, gdy trasa nie obsługuje/v1/models. Dedykowany provider wstrzykuje zaufane nagłówki inference-objective i fairness według ścieżki użytkownika. - Z.ai GLM Coding Plan – ustaw
ZAI_BASE_URL=https://api.z.ai/api/coding/paas/v4. - Reasoning effort w Z.ai –
reasoning.effort(Chat Completions i Responses) jest wysyłane jakoreasoning_effortna najwyższym poziomie requestu Z.ai. GLM-5.3 i GLM-5.3-Flash zawsze myślą i akceptują tylkolow,highimax, więcnoneiminimalsą mapowane nalow,mediumnahigh, axhighnamax. Pozostałe modele GLM otrzymują poziom bez zmian. - Reasoning i transkrypcje w Groq – w rodzinach gpt-oss i qwen3 GoModel
domyślnie ustawia
reasoning_formatGroqa naparsed, więc chain of thought trafia doreasoningzamiast jako tekst<think>…</think>wewnątrz odpowiedzi. Aby to nadpisać, wyślijreasoning_formatsamodzielnie (rawlubhidden). Z odpowiedzi JSON dla transkrypcji i tłumaczeń usuwane jest specyficzne dla Groqa polex_groq, aby pasowały do formatu OpenAI. - Regiony MiniMax i aktualne modele tekstowe – domyślny globalny endpoint to
https://api.minimax.io/v1; konta na platformie chińskiej powinny ustawićMINIMAX_BASE_URL=https://api.minimaxi.com/v1. Aktualne ID modeli tekstowych toMiniMax-M3(kontekst 1 000 000 tokenów; wejście tekstowe, obrazy i wideo) orazMiniMax-M2.7(kontekst 204 800 tokenów; wejście tekstowe). Ceny w USD za milion tokenów: dla M3 0,60 za wyjście i 0,12 za wejście, 1,20 za wejście z cache i 0,375 $ za zapis do cache. M3 obsługuje thinking adaptacyjny lub wyłączony; M2.7 zawsze myśli. - Amazon Bedrock Mantle – GPT-5.6 Sol, Terra i Luna akceptują w Mantle
wyłącznie Responses API. GoModel wysyła requesty
/v1/responsesbezpośrednio do AWS i wybiera wymaganą ścieżkę upstream/openai/v1/responses. - Fireworks AI – ID modeli to ścieżki w zakresie konta, takie jak
accounts/fireworks/models/gpt-oss-120b; używaj ich dosłownie w requestach i wFIREWORKS_MODELS. - ElevenLabs – provider wyłącznie głosowy:
/v1/audio/speech(text-to-speech) i/v1/audio/transcriptions(speech-to-text) są obsługiwane, ale chat,/v1/responsesi embeddingi nie (oznaczenia ❌ powyżej wynikają z tego, a nie z ograniczeń gatewaya). Polevoicez OpenAI musi być voice_id ElevenLabs. Obsługiwane formaty audio i modele speech-to-text opisuje przewodnik ElevenLabs. - Chutes AI – domyślnie używa
https://llm.chutes.ai/v1i wykrywa aktualne ID modeli, limity kontekstu, możliwości i ceny z bieżącego katalogu. GoModel tłumaczy requesty/v1/responsesna chat completions; współdzielony endpoint LLM Chutes nie udostępnia embeddingów. Obsługa passthrough wymaga jawnego włączenia przez operatora – dodaniachutesdoENABLED_PASSTHROUGH_PROVIDERS. - Meta (Muse Spark) – Meta Model API jest kompatybilne z OpenAI; ustaw
META_API_KEYi kieruj requesty domuse-spark-1.1. Modeli Muse Spark nie ma jeszcze w katalogu modeli upstream, więc jeśli chcesz śledzić koszty i raportować okno kontekstu, zadeklarujcontext_windowipricingw metadanychproviders.meta.modelswconfig.yaml. - Kilo AI – ID modeli mają postać
provider/model(na przykładanthropic/claude-sonnet-4.5) i są przekazywane bez zmian. GoModel obsługuje/v1/responses, tłumacząc je na endpoint chat-completions Kilo. Jeśli inny skonfigurowany provider udostępnia to samo surowe ID modelu, wybierz Kilo jawnie przezkilo/anthropic/claude-sonnet-4.5; przed przekazaniem GoModel usuwa tylko zewnętrzny kwalifikator routingukilo/. - Eden AI – ID modeli mają postać
provider/model(na przykładopenai/gpt-4) i są przekazywane bez zmian; wybierz Eden jawnie przezedenai/openai/gpt-4, gdy inny skonfigurowany provider udostępnia to samo surowe ID. GoModel wykrywa katalog Eden, okna kontekstu, możliwości i ceny za token z własnego/v3/modelsEden, więc nie ma wbudowanej listy modeli, a nowe modele Eden nie wymagają aktualizacji. Koszt pojedynczego requestu pochodzi z dokładnej wartościcostw USD, którą Eden zwraca w każdej odpowiedzi, a nie z wyliczeń na podstawie tokenów. GoModel obsługuje/v1/responses, tłumacząc je na endpoint chat-completions Eden – własne/v3/responsesEden to inne API i nigdy nie jest używane. Zobacz przewodnik Eden AI. - Xiaomi MiMo – TTS (
mimo-v2.5-tts*) i ASR (mimo-v2.5-asr) są obsługiwane przez/v1/audio/speechi/v1/audio/transcriptions(tłumaczone na dialekt audio chat-completions MiMo), a także bezpośrednio przez chat completions; aby uzyskać kontekst 1M, dopisz[1m]do ID modelu i dodaj je doXIAOMI_MODELS. - OpenCode Go (OpenCode Zen) – routing per model: większość modeli używa
/chat/completionsw stylu OpenAI, a modele obsługujące wyłącznie/messages(domyślnieqwen3.7-max, nadpisz przezOPENCODE_GO_MESSAGES_MODELS) są wysyłane do natywnego endpointu Anthropic. Do requestów chat bez parametru reasoning wstrzykiwane jestreasoning_effort: "low", bo niektóre modele zawsze myślą i odrzucają requesty, które go pomijają (nadpisz przezOPENCODE_GO_DEFAULT_REASONING_EFFORT). UstawOPENCODE_GO_API_KEY; base URL domyślnie tohttps://opencode.ai/zen/go/v1. - Subskrypcja ChatGPT – obsługuje wyłącznie
/v1/responses, rozliczane z limitu planu ChatGPT, a nie z kredytów API. Upstream akceptuje ścisłą listę dozwolonych parametrów i działa tylko w trybie streamingu; GoModel dostosowuje requesty i składa stream w całość dla wywołań bez streamingu. UstawCHATGPT_API_KEYna token dostępu zcodex login. Raportowany koszt nie jest faktycznym wydatkiem: te ID modeli istnieją też na OpenAI Platform, więc rejestr przypisuje ich ceny za token do ruchu w ramach subskrypcji o stałej opłacie – nie stosuj do niego budżetów ani load balancingucost. - Kimi Code – brak cen za token; limit odnawia się co tydzień i jest dodatkowo
ograniczony kroczącym oknem 5-godzinnym. Śledzenie kosztów użycia raportuje
zero dla Kimi Code, więc load balancing
costnie może go wycenić; preferuj zachowawcze strategie retry. - Hetzner (eksperymentalny) – Hetzner określa API inferencji jako
eksperymentalne: spodziewaj się zmian łamiących kompatybilność i braku SLA.
Katalog modeli i okna limitów żądań zmieniają się w trakcie eksperymentu;
odpytuj bieżący endpoint
/v1/modelsi oficjalną dokumentację zamiast polegać na zrzutach. Przykładowe ID modelu w tabeli powyżej (Qwen/Qwen3.6-35B-A3B-FP8) to wpis z oficjalnej dokumentacji Hetznera z 2026-08-17 i w chwili czytania może być inne. W fazie eksperymentalnej usługa jest bezpłatna, więc śledzenie kosztów użycia raportuje zero, a load balancingcostnie może jej wycenić. Brak endpointu embeddingów; tylko chat,/v1/responses(przez chat), lista modeli i passthrough. Passthrough to ogólny mechanizm przekazywania – ✅ oznacza możliwość adaptera; tolerancja Hetznera na dowolne ścieżki upstream nie jest zweryfikowana, dopóki API jest eksperymentalne.hetznerznajduje się na domyślnej liścieENABLED_PASSTHROUGH_PROVIDERS, więc trasy/p/hetzner/...działają bez włączania przez operatora; usuń go z listy, aby je zablokować. - Skonfigurowane listy modeli – dostępne dla każdego providera przez
<PROVIDER>_MODELS, na przykładOPENROUTER_MODELS=openai/gpt-oss-120b,anthropic/claude-sonnet-4lubORACLE_MODELS=openai.gpt-oss-120b,xai.grok-3. DeepSeek domyślnie używahttps://api.deepseek.com; ustawDEEPSEEK_BASE_URLtylko wtedy, gdy używasz kompatybilnego proxy lub alternatywnego endpointu DeepSeek. DomyślnieCONFIGURED_PROVIDER_MODELS_MODE=fallbackużywa tych list tylko wtedy, gdy/modelsupstreamu jest niedostępne lub puste. UstawCONFIGURED_PROVIDER_MODELS_MODE=allowlist, aby udostępniać tylko skonfigurowane modele dla providerów, które definiują listę, z pominięciem wywołań/modelsw ich upstreamie. - Filtry modeli – zawężaj duży katalog wzorcem glob lub ceną zamiast
wymieniać modele jeden po drugim:
OPENROUTER_MODEL_FILTER_INCLUDE=*:freezostawia tylko darmowe modele OpenRouter, a<PROVIDER>_MODEL_FILTER_MAX_PRICE_PER_MTOKogranicza, do czego provider może kierować requesty. Zobacz Filtrowanie modeli providera. - Kategorie modeli (chat, embeddingi, audio) – kategoria modelu wynika z jego
modes, ustalanych z czterech źródeł w kolejności pierwszeństwa: zdalny rejestr modeli, metadane operatora zadeklarowane wproviders.<name>.modelswconfig.yaml(np.modes: [embedding]), sygnały możliwości z listy modeli samego providera (GeminisupportedGenerationMethods, Cohereendpoints, modalności architektury OpenRouter, możliwości z/api/showw Ollama) i na końcu zachowawcze sprawdzenie nazwy dla modeli wciąż niesklasyfikowanych: ID zawierająceembedlub pasujące do znanych rodzin modeli embeddingowych (bge,e5,gte,minilm) są kategoryzowane jako modele do embeddingów, a ID zawierającererank– jako modele do rerankingu; w przypadku ID z przestrzenią nazw, takich jakorg/model, sprawdzany jest ostatni segment ścieżki. Deklaruj metadane operatora tylko wtedy, gdy model po tym wszystkim pozostaje niesklasyfikowany. Kategorie wpływają tylko na grupowanie w dashboardzie;/v1/embeddingskieruje requesty do dowolnego modelu obsługiwanego przez providera niezależnie od kategorii. - vLLM – ustaw
VLLM_API_KEYtylko wtedy, gdy serwer upstream uruchomiono z--api-key. - audio.cpp –
AUDIOCPP_BASE_URLjest wymagane (domyślny port audiocpp_server koliduje z portem 8080 samego GoModel, więc nie ma wartości domyślnej);AUDIOCPP_API_KEYzwykle nie jest ustawiane, bo audio.cpp nie ma własnego uwierzytelniania. Tylko audio: kierowane są do niego/v1/audio/speechi/v1/audio/transcriptions, a jego trasy szczegółów, wyrównania i streamingu na żywo są dostępne przez passthrough. Zobacz audio.cpp. - Jev / Kev – System One API od TypeSafe to API decyzyjne (na wejściu stan i
typowane pytania, na wyjściu skalibrowane prawdopodobieństwa). GoModel
przekazuje je natywnie, bez tłumaczenia, pod
POST /v1/systemone(z modelami wirtualnymi, guardrails, audytem i użyciem) oraz przez passthrough pod/p/jev/..., a także odpowiada nim na Decisions API OpenAI podPOST /v1/decisions, tłumacząc w obie strony./v1/decisionsjest dostępne po skonfigurowaniu provideraopenai,jevlubopenrouter, a/v1/systemonepo skonfigurowaniu providerajevlubopenrouter; OpenRouter obsługuje Jev natywnie, a jego modele decyzyjne są wymienione jako modele użytkowe (utility).JEV_API_KEYkonfiguruje hostowane API; dla self-hosted serwera Kev, który obsługuje to samo API bez uwierzytelniania, ustawJEV_BASE_URLi pozostaw klucz nieustawiony. Zobacz Jev. - llama.cpp / LM Studio –
LLAMACPP_BASE_URLjest wymagane (domyślny port llama-server koliduje z portem 8080 samego GoModel, więc nie ma wartości domyślnej);LLAMACPP_API_KEYjest opcjonalne. Nie rejestruj tych serwerów jakoollama, bo ten typ używa natywnego API Ollamy. Zobacz llama.cpp. - llm-d –
LLMD_BASE_URLjest wymagane.LLMD_API_KEYjest opcjonalne i jest wysyłane tylko wtedy, gdy Gateway przed Routerem wymaga uwierzytelniania bearer. - SGLang – ustaw
SGLANG_API_KEYtylko wtedy, gdy serwer upstream uruchomiono z--api-key; w przeciwnym razie wystarczySGLANG_BASE_URL. - Wiele kluczy API dla jednego providera – ustaw
OPENAI_API_KEY_2,OPENAI_API_KEY_3itd., aby rozłożyć sesje na wiele kluczy, zachowując każdą rozmowę na jednym kluczu ze względu na powinowactwo prompt cache. Zobacz Rotacja kluczy API. - Wiele instancji jednego typu providera – bez
config.yamlużyj zmiennych środowiskowych z sufiksem, takich jakOPENAI_EAST_API_KEYiOPENAI_EAST_BASE_URL; dodajOPENAI_EAST_MODELS, aby skonfigurować listę modeli tej instancji. To rejestruje provideraopenai-easttypuopenai. Vertex AI stosuje ten sam wzorzec sufiksów –VERTEX_US_PROJECTrejestruje provideravertex-us. Zmienne środowiskowe projektu i lokalizacji Vertex muszą pasować do prefiksu instancji: dla instancji z sufiksem, takiej jakVERTEX_US_PROJECT, ustaw teżVERTEX_US_LOCATIONi wszystkie inne ustawienia z sufiksem dla tej instancji zamiast ogólnychVERTEX_PROJECT/VERTEX_LOCATION.VERTEX_AUTH_TYPEdomyślnie używa Application Default Credentials (gcp_adc).
Co GoModel normalizuje w odpowiedziach
GoModel zwraca jeden format każdego pola niezależnie od tego, który provider odpowiedział, a wszystko inne przekazuje dokładnie tak, jak wysłał to provider.- Tekst reasoningu wraca jako
reasoning_content, wchoices[].messagei w streamowanychchoices[].delta. Groq zwraca go jakoreasoning; GoModel zmienia nazwę, więc ten sam kod klienta odczytuje chain of thought z Groq, DeepSeek, Anthropic, Cohere i vLLM. - Pola specyficzne dla vendora nie są usuwane.
x_groqz Groqa i jego czasy użyciaqueue_time/prompt_time/completion_timeorazprompt_cache_hit_tokens/prompt_cache_miss_tokensz DeepSeek docierają do klienta nietknięte – dzięki temu passthrough masz dostęp do natywnych dodatków providera bez czekania na release GoModel. Jeśli chcesz pisać kod niezależny od providera, odczytuj cache hity z przenośnegousage.prompt_tokens_details.cached_tokens. Zobacz ADR-0011. - Streamy zawierają końcowe
usage, nawet jeśli o nie nie prosisz. Przy włączonym śledzeniu użycia GoModel dodajestream_options.include_usagedo każdego requestu ze streamingiem, aby móc wycenić wywołanie, a chunk z użyciem od providera jest przekazywany bez zmian; własne API OpenAI pomija użycie, dopóki klient o nie nie poprosi. Większość providerów wysyła je jako osobny końcowy chunk z pustą tablicąchoices, DeepSeek dołącza je do ostatniego chunka z treścią. Zignoruj to pole albo ustawENFORCE_RETURNING_USAGE_DATA=false, aby GoModel przestał o nie prosić – kosztem braku rekordów użycia dla streamowanych requestów u providerów, które raportują użycie tylko na żądanie.
Dlaczego niektórzy providerzy mają dedykowane strony
To providerzy, z którymi użytkownicy najczęściej mają problemy:- Google Vertex AI – wymaga projektu GCP, regionu oraz Application Default Credentials albo klucza JSON konta serwisowego.
- Amazon Bedrock – nie ma własnego klucza API; używa łańcucha danych uwierzytelniających AWS i wymaga jawnego dostępu do modeli w konsoli Bedrock.
- Azure OpenAI – base URL-e w zakresie wdrożenia, parametr zapytania
api-versioni nagłówekapi-keyzamiastAuthorization: Bearer. - Oracle GenAI – wymaga polityki OCI IAM dla
generativeaiapikeyi regionalnego URL-a endpointu kompatybilnego z OpenAI. - Google Gemini (AI Studio) – dwa tryby routingu (natywny
generateContenti kompatybilny z OpenAI) z różną obsługą wejścia w postaci obrazów. - Anthropic – reasoning effort jest mapowany na adaptive thinking i kontrolę effort w Claude, które różnią się między generacjami modeli.
- DeepSeek – osobliwości mapowania reasoning effort dla DeepSeek V4.
- Ollama / SGLang / vLLM – hosting modeli lokalnych z opcjonalną konfiguracją wielu instancji przez zmienne środowiskowe z sufiksem i ID modeli z prefiksem providera.
- Xiaomi MiMo – tryb thinking domyślnie włączony, sufiks kontekstu
[1m]oraz TTS/ASR działające przez chat completions zamiast natywnych endpointów audio. - OpenCode Go – OpenCode Zen dzieli modele między
/chat/completionsw stylu OpenAI i natywne dla Anthropic/messages; GoModel kieruje requesty per model (zestaw modeli obsługujących wyłącznie/messagesjest utrzymywany ręcznie, domyślnieqwen3.7-max). - Subskrypcja ChatGPT – upstream obsługujący wyłącznie Responses, ze ścisłą listą dozwolonych parametrów, używany do postawienia GoModel między Codexem a planem ChatGPT.
Status providerów
Dashboard administracyjny (/admin/dashboard) pokazuje bieżący status każdego
skonfigurowanego providera w sekcji Providers Overview na stronie
Overview.
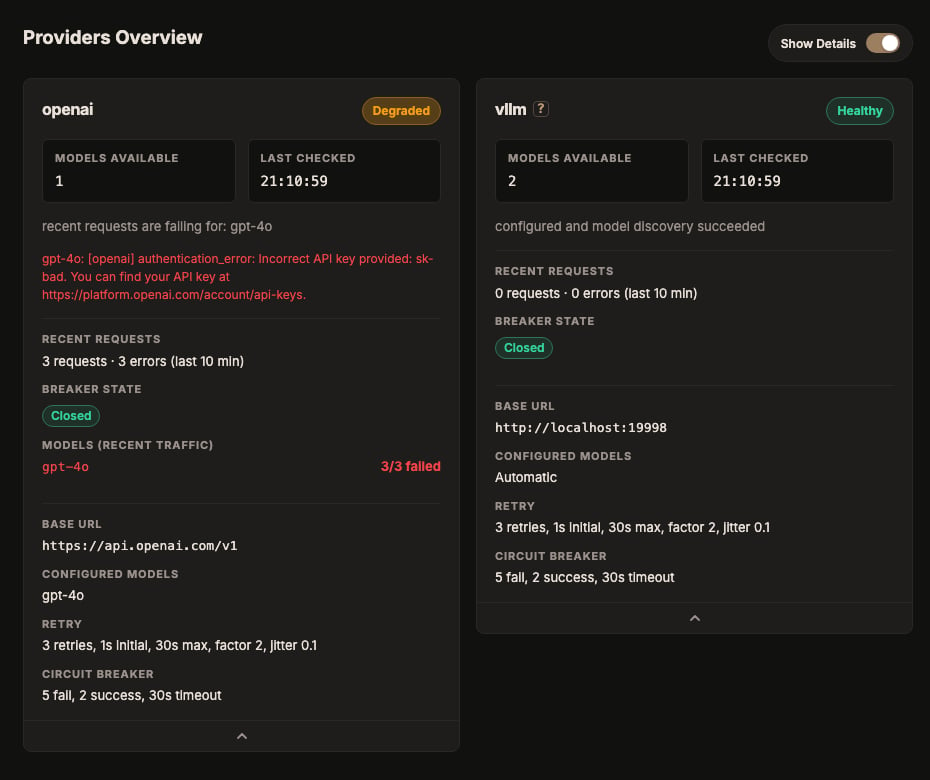
Rozwiń kartę (pasek ze strzałką na dole albo przełącznik Show Details dla
całej sekcji), aby zobaczyć szczegóły zdrowia requestów:
- Recent Requests – requesty i błędy przez gateway w ciągu ostatnich 10 minut.
- Breaker State – bieżący stan circuit breakera providera (zobacz Odporność na awarie).
- Models (Recent Traffic) – liczba requestów i błędów per model. Model z co
najmniej 3 błędami stanowiącymi połowę lub więcej jego requestów w danym oknie
jest oznaczany na czerwono – pozwala to wychwycić pojedynczy zepsuty model u
providera, który poza tym działa poprawnie, czego samo wykrywanie modeli nie
zauważy. Najedź na wiersz, aby zobaczyć ostatni komunikat błędu modelu.
Odpowiedź
200bez choices, bez outputu lub bez użycia tokenów również liczy się tu jako błąd.
GET /admin/providers/status do
skryptów i zewnętrznego monitoringu.