

不使用环境变量配置提供商
下面的每个凭据(OPENAI_API_KEY、ANTHROPIC_API_KEY 等)也可以在管理控制台(/admin/dashboard)的 Providers 页面中设置,无需重启。这是在不设置任何提供商环境变量的情况下运行 GoModel 的最简单方式:在不配置任何提供商的情况下启动网关(模型目录初始为空;网关仍会正常启动并提供控制台),然后在 UI 中添加提供商。通过这种方式添加的提供商会立即注册到正在运行的网关中。
通过环境变量或 config.yaml 声明的提供商始终优先:以任一方式配置的名称在控制台中都是只读的(显示 “Config” 徽标),这与 GoModel 对 MCP 服务器、虚拟模型和速率限制采用的规则相同。API 密钥和服务账号 Secret(密钥)保存后会被遮蔽(***):编辑提供商时,所有未修改的内容都会重新提交 ***,网关会保留已存储的值。禁用提供商(而不是删除)会将其从路由中注销,但保留其配置记录。环境变量支持的多密钥轮换(api_keys,有序列表)和按提供商配置的出站代理同样可以在控制台表单中配置。
支持的提供商
示例模型标识符仅作说明,可能会发生变化;当前可用的模型请查阅各提供商的模型目录。功能列反映的是网关的 API 支持情况,而不是上游提供商提供的每个模型的具体能力。
✅ 支持 ❌ 不支持
提供商说明
- OpenAI 推理模型:对于 o 系列以及 GPT-5 或更高版本的模型(包括 GPT-6),GoModel 会将
max_tokens作为max_completion_tokens发送,并丢弃temperature和top_p,除非reasoning_effort为"none"(这是这些模型唯一接受这两个参数的情况)。OpenAI 会拒绝这些模型的stop参数,因此 GoModel 会自行在第一个停止序列处截断输出,并在stop_sequence中报告。如果reasoning_effort的值不被模型接受,会调整为模型支持的最接近级别(例如,从 GPT-5.1 起minimal变为low,max变为xhigh)。从 GPT-5.6 起,OpenAI 仅在reasoning_effort: "none"时才接受 Chat Completions 上的函数工具,因此未设置推理强度的工具请求会被设为"none"。 - 通过 Responses 处理的 OpenAI 请求:部分聊天请求(Chat Completions 和
/v1/messages)无法由 OpenAI 的 Chat Completions 处理:GPT-5.6+ 上带推理强度的函数工具、GPT-6 Astra 和 GPT-6.1 上的任何工具调用(它们拒绝"none")、包含图片或文件的工具结果(Chat Completions 会接受,但模型根本看不到这些内容),以及通过 URL 提供的文件。GoModel 会以store: false将这些请求发送到 OpenAI 的/v1/responses,并返回普通的 Chat Completion 或数据块流。如果请求中包含 Responses API 没有对应项的字段(例如n或logprobs),则仍使用 Chat Completions。 - llm-d:将
LLMD_BASE_URL指向 Router/EPP 服务;当该路由不提供/v1/models时,请声明LLMD_MODELS。该专用提供商会注入受信任的推理目标(inference-objective)和用户路径公平性请求头。 - Z.ai GLM Coding Plan:设置
ZAI_BASE_URL=https://api.z.ai/api/coding/paas/v4。 - Z.ai 推理强度:
reasoning.effort(Chat Completions 和 Responses)会作为 Z.ai 的顶层reasoning_effort发送。GLM-5.3 和 GLM-5.3-Flash 始终进行思考,且只接受low、high和max,因此none和minimal映射为low,medium映射为high,xhigh映射为max。其他 GLM 模型按原样接收该级别。 - Groq 推理与转录:对于 gpt-oss 和 qwen3 系列,GoModel 默认将 Groq 的
reasoning_format设为parsed,因此思维链会出现在reasoning中,而不是以内联<think>…</think>文本的形式出现在答案中。如需覆盖,请自行发送reasoning_format(raw或hidden)。JSON 格式的转录和翻译响应会移除 Groq 的厂商成员x_groq,使其与 OpenAI 的结构一致。 - MiniMax 区域与当前文本模型:默认的全球端点为
https://api.minimax.io/v1;中国大陆平台的账户应设置MINIMAX_BASE_URL=https://api.minimaxi.com/v1。当前的文本模型 ID 为MiniMax-M3(1,000,000 Token 上下文;支持文本、图片和视频输入)和MiniMax-M2.7(204,800 Token 上下文;支持文本输入)。按每百万 Token 计的美元定价:M3 输入 $0.60、输出 $2.40、缓存输入 $0.12;M2.7 输入 $0.30、输出 $1.20、缓存输入 $0.06、缓存写入 $0.375。M3 支持自适应思考或禁用思考;M2.7 始终进行思考。 - Amazon Bedrock Mantle:GPT-5.6 Sol、Terra 和 Luna 在 Mantle 上只接受 Responses API。GoModel 会将
/v1/responses请求直接发送到 AWS,并选择所需的/openai/v1/responses上游路径。 - Fireworks AI:模型 ID 是账户作用域的路径,例如
accounts/fireworks/models/gpt-oss-120b;请在请求和FIREWORKS_MODELS中原样使用。 - ElevenLabs:仅语音的提供商:支持
/v1/audio/speech(文本转语音)和/v1/audio/transcriptions(语音转文本),但不支持聊天、/v1/responses和嵌入(上表中的 ❌ 反映的是这一点,而不是网关的限制)。OpenAI 的voice字段必须是 ElevenLabs 的 voice_id。有关支持的音频格式和语音转文本模型,请参阅 ElevenLabs 指南。 - Chutes AI:默认使用
https://llm.chutes.ai/v1,并从实时目录中发现其当前的模型 ID、上下文限制、能力和定价。GoModel 会将/v1/responses请求转换为 Chat Completions;Chutes 的共享 LLM 端点不提供嵌入。透传支持需要运维人员显式启用,即将chutes添加到ENABLED_PASSTHROUGH_PROVIDERS。 - Meta (Muse Spark):Meta Model API 兼容 OpenAI;设置
META_API_KEY并路由到muse-spark-1.1。Muse Spark 模型尚未进入上游模型目录,因此如果需要成本追踪和上下文窗口报告,请在config.yaml的providers.meta.models元数据下声明context_window和pricing。 - Kilo AI:模型 ID 使用
provider/model格式(例如anthropic/claude-sonnet-4.5),并原样转发。GoModel 通过将/v1/responses转换为 Kilo 的 Chat Completions 端点来提供该接口。如果另一个已配置的提供商提供了相同的原始模型 ID,请使用kilo/anthropic/claude-sonnet-4.5显式选择 Kilo;GoModel 在转发前只会移除外层的kilo/路由限定符。 - Eden AI:模型 ID 使用
provider/model格式(例如openai/gpt-4),并原样转发;当另一个已配置的提供商提供了相同的原始 ID 时,请使用edenai/openai/gpt-4显式选择 Eden。GoModel 从 Eden 自身的/v3/models中发现其模型目录、上下文窗口、能力和按 Token 计的定价,因此没有内置模型列表,新的 Eden 模型也无需升级即可使用。每个请求的成本来自 Eden 在每个响应中返回的精确美元cost,而不是基于 Token 计算。GoModel 通过将/v1/responses转换为 Eden 的 Chat Completions 端点来提供该接口;Eden 自身的/v3/responses是另一套 API,永远不会被使用。参阅 Eden AI 指南。 - Xiaomi MiMo:TTS(
mimo-v2.5-tts*)和 ASR(mimo-v2.5-asr)既可以通过/v1/audio/speech和/v1/audio/transcriptions提供(转换为 MiMo 的 Chat Completions 音频协议),也可以直接通过 Chat Completions 使用;如需 1M 上下文,请在模型 ID 后追加[1m],并将其列入XIAOMI_MODELS。 - OpenCode Go(OpenCode Zen):按模型路由:大多数模型使用 OpenAI 风格的
/chat/completions,而仅支持/messages的模型(默认为qwen3.7-max,可通过OPENCODE_GO_MESSAGES_MODELS覆盖)会发送到 Anthropic 原生端点。没有推理参数的聊天请求会被注入reasoning_effort: "low",因为部分模型始终进行思考,并会拒绝省略该参数的请求(可通过OPENCODE_GO_DEFAULT_REASONING_EFFORT覆盖)。请设置OPENCODE_GO_API_KEY;Base URL 默认为https://opencode.ai/zen/go/v1。 - ChatGPT 订阅:仅提供
/v1/responses,按 ChatGPT 套餐配额计费,而不是 API 额度。上游只接受严格的参数白名单且仅支持流式传输;GoModel 会适配请求,并为非流式调用方合并流。请将CHATGPT_API_KEY设置为codex login获取的访问 Token。报告的成本并非实际支出:这些模型 ID 在 OpenAI Platform 上同样存在,因此注册表会将其按 Token 计的价格套用到固定费率的订阅流量上。请不要对其使用预算和cost负载均衡。 - Kimi Code:没有按 Token 计的定价;配额每周刷新,同时还受滚动 5 小时窗口的限制。用量成本追踪对 Kimi Code 报告为零,因此
cost负载均衡无法为其定价;建议采用保守的重试策略。 - Hetzner(实验性):Hetzner 声明其推理 API 处于实验阶段:可能出现破坏性变更,且不提供 SLA。实验期间,模型目录和速率限制窗口会发生变化;请查询实时的
/v1/models端点和官方文档,而不要依赖快照。上表中的示例模型 ID(Qwen/Qwen3.6-35B-A3B-FP8)取自 2026-08-17 的 Hetzner 官方文档,阅读时可能已有所不同。实验期间免费,因此用量成本追踪报告为零,cost负载均衡也无法为其定价。没有嵌入端点;仅支持聊天、/v1/responses(通过 Chat 转换)、模型列表和透传。透传是通用的转发器,✅ 标记表示适配器具备该能力;在 API 处于实验阶段时,Hetzner 对任意上游路径的兼容性尚未验证。hetzner已包含在默认的ENABLED_PASSTHROUGH_PROVIDERS白名单中,因此/p/hetzner/...路由无需运维人员启用即可使用;如需限制,请将其从列表中移除。 - 配置的模型列表:所有提供商都可以通过
<PROVIDER>_MODELS配置,例如OPENROUTER_MODELS=openai/gpt-oss-120b,anthropic/claude-sonnet-4或ORACLE_MODELS=openai.gpt-oss-120b,xai.grok-3。DeepSeek 默认使用https://api.deepseek.com;仅在使用兼容代理或其他 DeepSeek 端点时才需设置DEEPSEEK_BASE_URL。默认情况下,CONFIGURED_PROVIDER_MODELS_MODE=fallback仅在上游/models不可用或为空时使用这些列表。设置CONFIGURED_PROVIDER_MODELS_MODE=allowlist后,对于定义了列表的提供商,只暴露已配置的模型,并跳过其上游/models调用。 - 模型过滤器:按 glob 模式或价格缩小大型模型目录,而无需逐个列出模型:
OPENROUTER_MODEL_FILTER_INCLUDE=*:free只保留 OpenRouter 的免费模型,<PROVIDER>_MODEL_FILTER_MAX_PRICE_PER_MTOK限制提供商可路由到的模型价格上限。参阅过滤提供商的模型。 - 模型分类(聊天、嵌入、音频):模型的分类来自其
modes,按优先级从四个来源确定:远程模型注册表;在config.yaml的providers.<name>.models下声明的运维元数据(例如modes: [embedding]);提供商自身模型列表中的能力信号(Gemini 的supportedGenerationMethods、Cohere 的endpoints、OpenRouter 的架构模态、Ollama 的/api/show能力);最后,对仍未分类的模型进行保守的名称检查:ID 中包含embed或匹配常见嵌入模型系列(bge、e5、gte、minilm)的归类为嵌入模型,ID 中包含rerank的归类为重排序模型;org/model这类带命名空间的 ID 按其最后一个路径段检查。只有在经过以上所有步骤后模型仍未分类时,才需要声明运维元数据。分类仅影响控制台中的分组;无论分类如何,/v1/embeddings都会路由到该提供商提供的任意模型。 - vLLM:仅当上游服务器使用
--api-key启动时,才需设置VLLM_API_KEY。 - audio.cpp:
AUDIOCPP_BASE_URL为必填项(audiocpp_server 的默认端口与 GoModel 自身的 8080 冲突,因此没有默认值);AUDIOCPP_API_KEY通常不设置,因为 audio.cpp 本身没有认证机制。仅支持音频:/v1/audio/speech和/v1/audio/transcriptions会路由到它,其详情、对齐和实时流式传输路由可以通过透传访问。参阅 audio.cpp。 - Jev / Kev:TypeSafe 的 System One API 是一个决策 API(输入状态和类型化问题,输出校准后的概率)。GoModel 在
POST /v1/systemone上原生、不经转换地转发该 API(支持虚拟模型、护栏、审计和用量),也可以通过/p/jev/...透传访问;同时,GoModel 通过双向转换,使用它来响应 OpenAI 的 Decisions API(POST /v1/decisions)。配置了openai、jev或openrouter提供商后,/v1/decisions即可使用;配置了jev或openrouter提供商后,/v1/systemone即可使用;OpenRouter 原生提供 Jev,其决策模型被列为工具类(utility)模型。JEV_API_KEY用于配置托管 API;对于自托管的 Kev 服务器(使用相同的 API,但不需要认证),请设置JEV_BASE_URL并保持密钥未设置。参阅 Jev。 - llama.cpp / LM Studio:
LLAMACPP_BASE_URL为必填项(llama-server 的默认端口与 GoModel 自身的 8080 冲突,因此没有默认值);LLAMACPP_API_KEY为可选项。请勿将这些服务器注册为ollama,该类型使用 Ollama 的原生 API。参阅 llama.cpp。 - llm-d:
LLMD_BASE_URL为必填项。LLMD_API_KEY为可选项,仅当 Router 前面的 Gateway 要求 Bearer 认证时才会发送。 - SGLang:仅当上游服务器使用
--api-key启动时,才需设置SGLANG_API_KEY;否则只需设置SGLANG_BASE_URL。 - 同一提供商的多个 API 密钥:设置
OPENAI_API_KEY_2、OPENAI_API_KEY_3等,以便将会话分散到多个密钥上,同时让每个对话固定使用一个密钥,以保持提示词缓存亲和性。参阅 API 密钥轮换。 - 同一提供商类型的多个实例:在不使用
config.yaml的情况下,使用带后缀的环境变量,例如OPENAI_EAST_API_KEY和OPENAI_EAST_BASE_URL;添加OPENAI_EAST_MODELS可配置该实例的模型列表。这会注册类型为openai的提供商openai-east。Vertex AI 遵循相同的后缀模式:VERTEX_US_PROJECT会注册提供商vertex-us。Vertex 的项目和区域环境变量必须与实例前缀一致:对于VERTEX_US_PROJECT这样带后缀的实例,还需设置VERTEX_US_LOCATION以及该实例的其他带后缀设置,而不是通用的VERTEX_PROJECT/VERTEX_LOCATION。VERTEX_AUTH_TYPE默认为应用默认凭据(gcp_adc)。
GoModel 在响应中规范化的内容
无论由哪个提供商响应,GoModel 对每个字段都返回统一的结构,其余内容则按提供商发送的原样转发。- 推理文本以
reasoning_content的形式返回,位于choices[].message和流式传输的choices[].delta上。Groq 以reasoning返回该内容,GoModel 会将其重命名,因此同一份客户端代码即可读取来自 Groq、DeepSeek、Anthropic、Cohere 和 vLLM 的思维链。 - 厂商成员不会被移除。 Groq 的
x_groq及其queue_time/prompt_time/completion_time用量计时,以及 DeepSeek 的prompt_cache_hit_tokens/prompt_cache_miss_tokens,都会原封不动地到达客户端。借助这种透传,您无需等待 GoModel 发布新版本即可获取提供商原生的额外信息。如果希望代码与提供商无关,请从可移植的usage.prompt_tokens_details.cached_tokens中读取缓存命中数。参阅 ADR-0011。 - 即使您没有请求,流中也会包含最终的
usage。 开启用量追踪时,GoModel 会为每个流式请求添加stream_options.include_usage以便为调用计价,并将提供商的用量数据块原样转发;而 OpenAI 自身的 API 只有在客户端请求时才会返回用量。大多数提供商会将其作为单独的末尾数据块发送,其中choices数组为空;DeepSeek 则将其附加在最后一个内容数据块上。您可以忽略该成员,或设置ENFORCE_RETURNING_USAGE_DATA=false让 GoModel 不再请求它,代价是对于只在被请求时才报告用量的提供商,流式请求将没有用量记录。
为什么部分提供商有专门的页面
以下是大多数用户在配置时容易遇到问题的提供商:- Google Vertex AI:需要一个 GCP 项目、区域,以及应用默认凭据或服务账号 JSON 密钥。
- Amazon Bedrock:没有自己的 API 密钥;使用 AWS 凭据链,并且需要在 Bedrock 控制台中显式开通模型访问权限。
- Azure OpenAI:基于部署的 Base URL、
api-version查询参数,以及使用api-key请求头而不是Authorization: Bearer。 - Oracle GenAI:需要针对
generativeaiapikey的 OCI IAM 策略,以及特定区域的兼容 OpenAI 端点 URL。 - Google Gemini(AI Studio):两种路由模式(原生
generateContent与兼容 OpenAI),图片输入行为各不相同。 - Anthropic:推理强度映射到 Claude 的自适应思考和推理强度控制,不同代模型之间存在差异。
- DeepSeek:DeepSeek V4 的推理强度映射存在特殊之处。
- Ollama / SGLang / vLLM:本地模型托管,可通过带后缀的环境变量和带提供商前缀的模型 ID 进行可选的多实例配置。
- Xiaomi MiMo:默认开启思考模式,使用
[1m]上下文后缀,TTS/ASR 通过 Chat Completions 而不是原生音频端点运行。 - OpenCode Go:OpenCode Zen 将模型分布在 OpenAI 风格的
/chat/completions和 Anthropic 原生的/messages上;GoModel 按模型路由(仅支持/messages的模型集合需手动维护,默认为qwen3.7-max)。 - ChatGPT 订阅:仅支持 Responses 的上游,带有严格的参数白名单,用于在 Codex 与 ChatGPT 套餐之间部署 GoModel。
提供商状态
管理控制台(/admin/dashboard)在 Overview 页面的 Providers Overview 部分显示每个已配置提供商的实时状态。
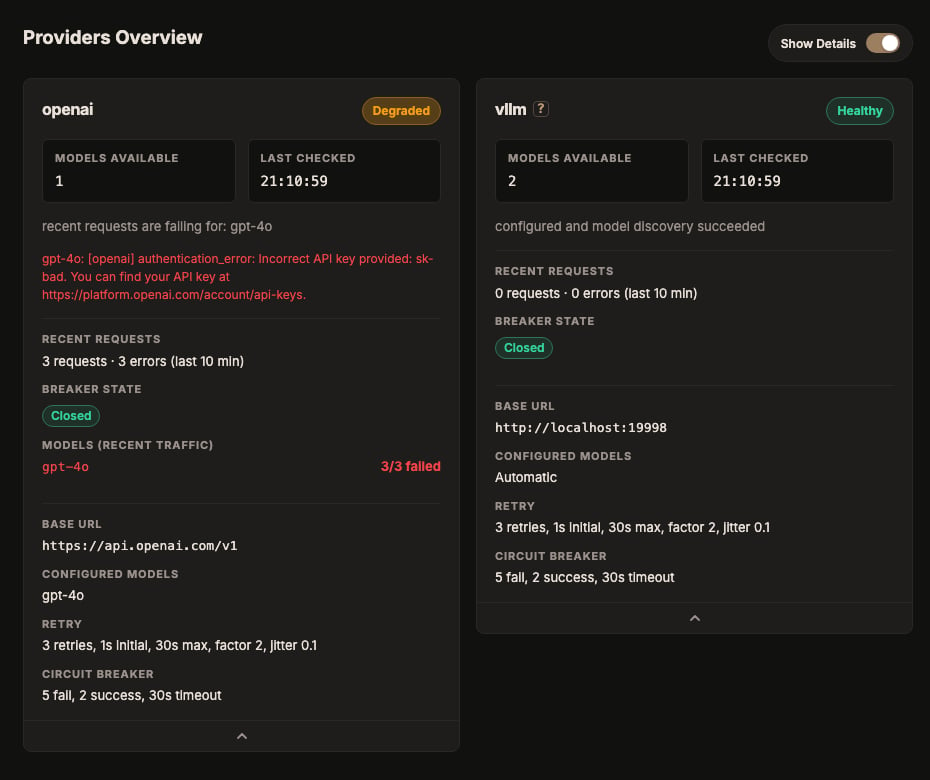
展开卡片(点击底部的箭头条,或使用整个部分的 Show Details 开关)可查看请求健康状况详情:
- Recent Requests:最近 10 分钟内经过网关的请求数和错误数。
- Breaker State:提供商熔断器的实时状态(参阅弹性与容错)。
- Models (Recent Traffic):按模型统计的请求/错误数。如果某个模型至少有 3 个错误,且错误占其时间窗口内请求数的一半或以上,就会以红色标记。这样可以发现原本健康的提供商上单个出问题的模型,而这是仅靠模型发现无法察觉的。将鼠标悬停在某一行上,可以查看该模型最新的错误消息。没有 choices、没有输出或没有 Token 用量的
200响应在这里同样计为错误。
GET /admin/providers/status 以 JSON 格式获取,便于编写脚本和进行外部监控。