

Übersicht
Ein Guardrail ist eine benannte, konfigurierte Instanz eines Plugins. Guardrails laufen in jedem Workflow, der auf sie verweist, und zwar in einer von drei Phasen:- prompt: nach dem Routing, bevor der Request den Provider erreicht
- response: auf der vollständigen Response, bevor sie den Client erreicht
- stream: auf jedem gestreamten Event (oder je nach Plugin auf dem gepufferten Stream)
/v1/responses kann ein Guardrail in der Stream-Phase Events verwerfen,
zusammenführen oder aufteilen, daher nummeriert GoModel das Ausgelieferte neu:
sequence_number läuft weiterhin lückenlos ab 0 bis zum abschließenden
response.completed (bzw. response.incomplete / response.failed bei einem
abgebrochenen Stream).
Guardrails funktionieren mit allen textbasierten Endpunkten:
/v1/chat/completions/v1/responses/v1/messages/v1/decisionsund/v1/systemone, nur in der Prompt-Phase (siehe Zusammenspiel mit verschiedenen Endpunkten)
Guardrails für Bild-, TTS-, STT- und Videomodelle sind als separates System
geplant und werden hier nicht behandelt.
Schnellstart
Fügen Sie Ihrerconfig/config.yaml einen Abschnitt guardrails hinzu:
Verwaltung über das Dashboard
Guardrail-Definitionen lassen sich statt inconfig.yaml auch im
Admin-Dashboard erstellen und bearbeiten – nützlich, um Regeln ohne erneutes
Deployment weiterzuentwickeln, oder für Betreiber, die die Konfiguration dieses
Repos nicht direkt verwalten.
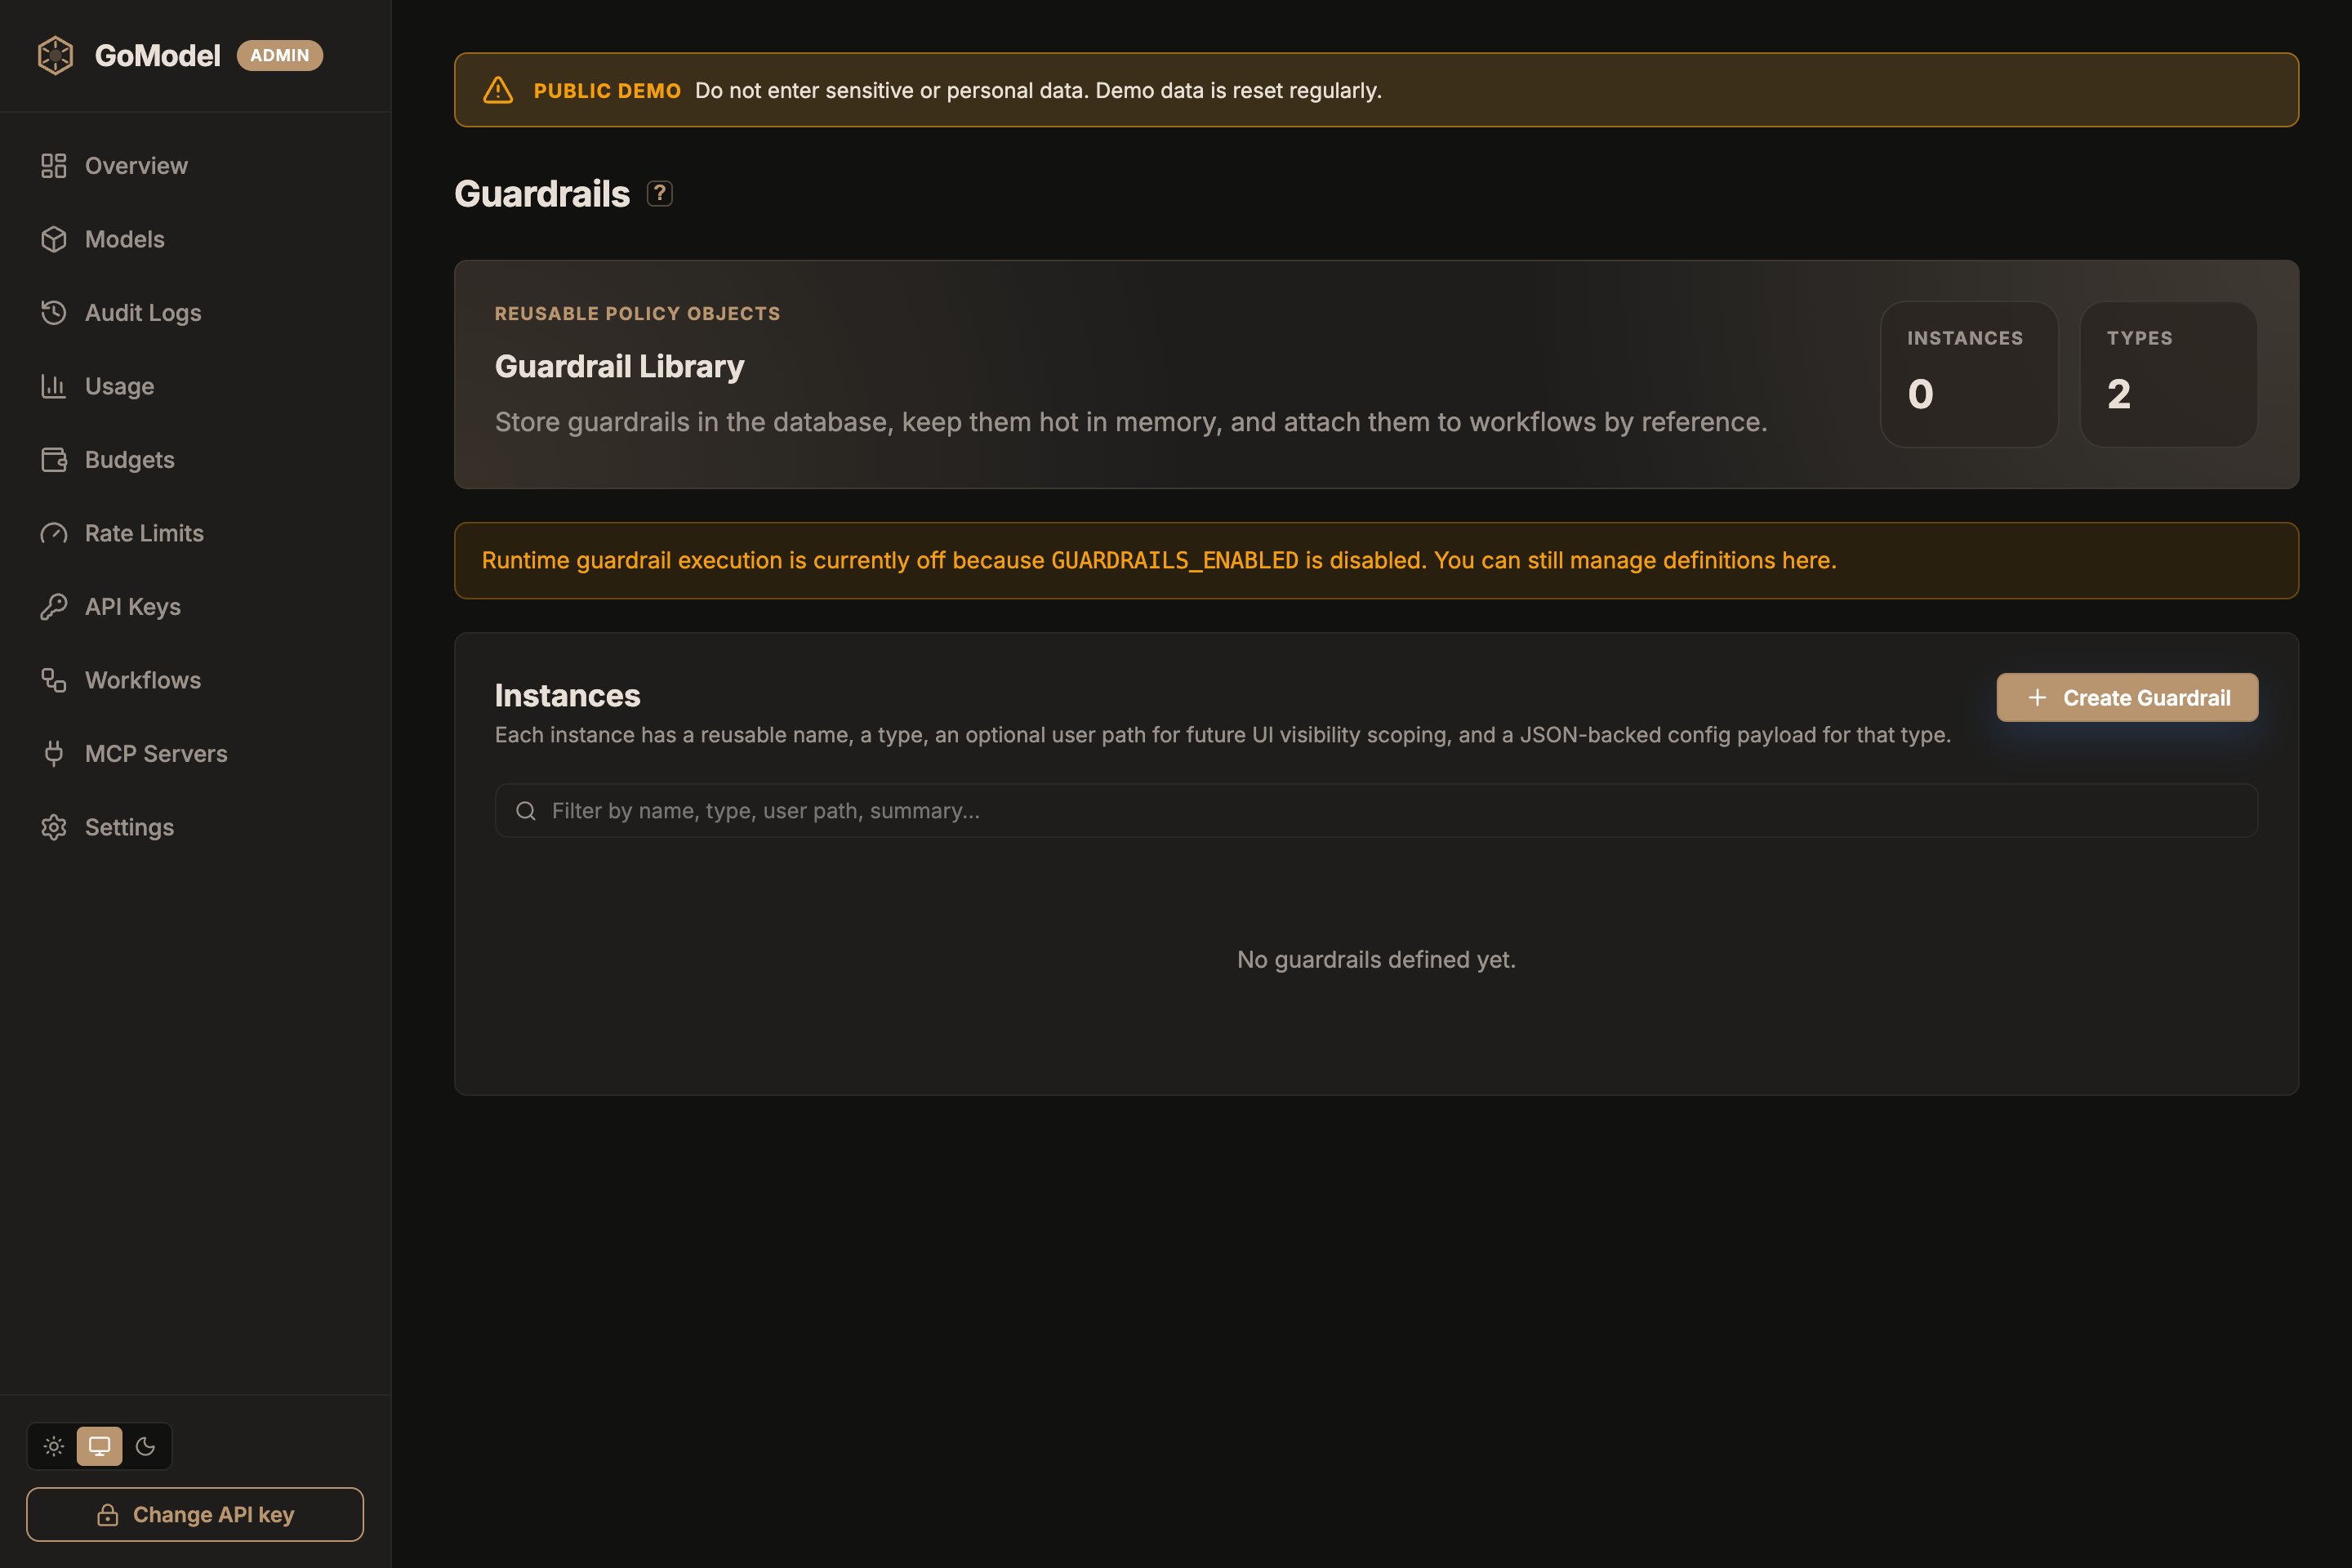
user_path ein und füllen Sie das Formular
aus, das das Plugin deklariert. Der Abschnitt Advanced enthält den
Fehlermodus und den Timeout. Einträge aus config.yaml werden beim Start in
denselben Speicher übernommen und bleiben mit ihm synchron, sodass im Dashboard
erstellte und in der Konfiguration deklarierte Guardrails nebeneinander
erscheinen. Die Liste Plugins unten auf der Seite zeigt jeden geladenen
Plugin-Typ mit seinen Hooks, seiner Quelle und seinem Zustand. Nicht jedes
Plugin ist ein Guardrail: Ein Plugin deklariert Guardrail: true in seinem
Manifest, wenn seine Instanzen eine Richtlinie auf Prompts, Responses oder
Streams anwenden, und das Dashboard kennzeichnet diese Plugins und die daraus
erstellten Instanzen mit einem Schild. Eine Routing-Strategie wie
cheapest_healthy wird auf derselben Seite aufgeführt, ist aber kein
Guardrail.
Die Ausführung von Guardrails zur Laufzeit hängt weiterhin von
GUARDRAILS_ENABLED ab. Ist die Option deaktiviert, können Sie Definitionen
auf der Seite trotzdem verwalten – sie laufen nur noch nicht auf dem
Live-Traffic.Funktionsweise
- Der Request wird auf einen einheitlichen
Promptabgebildet (System-, User-, Assistant- und Tool-Nachrichten mit stabilen IDs) - Die Prompt-Kette läuft: Jeder Guardrail bearbeitet den Prompt oder entscheidet sich für Blockieren, Antworten oder Warnen
- Die Bearbeitungen werden auf den ursprünglichen Request zurückübertragen, der dann an den Provider weitergeht
- Die Response-Kette läuft auf der vollständigen Response (bzw. die Stream-Kette auf dem Stream), bevor irgendetwas den Client erreicht
Exchange. Derselbe
Guardrail funktioniert für /chat/completions, /responses und /messages
identisch.
Ausführungsreihenfolge
Jeder Guardrail hat einenorder-Wert (den Workflow-Step), der steuert, wann er
innerhalb seiner Phase läuft:
- Gleiche Reihenfolge → Ausführung parallel (nebenläufig)
- Unterschiedliche Reihenfolge → Ausführung sequenziell (aufsteigend)
system_prompt, llm_based_altering,
string_replace, presidio), können sich keinen order-Wert mit einem anderen
bearbeitenden Guardrail teilen; pro order ist nur ein bearbeitender Guardrail
erlaubt, daneben beliebig viele nicht bearbeitende Prüfungen (llm_judge,
header_edit). Entscheiden mehrere Guardrails mit demselben order-Wert
unterschiedlich, gewinnt die strengste Entscheidung: block > respond >
warn > allow.
Konfiguration
Vollständige Struktur
system_prompt und llm_based_altering akzeptieren ihre Einstellungen auch in
einem typisierten Block, der nach dem Typ benannt ist (system_prompt: /
llm_based_altering:), wie im Schnellstart. Der typisierte Block und config:
sind gleichwertig; verwenden Sie config: für alle anderen Typen.
Zeilenorientierte Schlüssel wie string_replace.rules und die
header_edit-Listen akzeptieren entweder einen Block-Skalar (|) oder eine
YAML-Liste von Strings, die mit Zeilenumbrüchen verbunden werden.
Umgebungsvariable
Sie können Guardrails ein- und ausschalten, ohne die Konfigurationsdatei zu bearbeiten:PLUGINS_ENABLED,
standardmäßig deaktiviert). Sind beide deaktiviert, stehen die
Guardrail-Endpunkte und die Dashboard-Seite nicht zur Verfügung.
Regelfelder
Guardrail-Typen
GoModel liefert sechs Typen mit. Jeder ist ein eingebautes Plugin; die Tabellen listen seine Konfigurationsschlüssel so auf, wie sie unterconfig: und im
Dashboard-Formular erscheinen.
system_prompt
Fügt den System-Prompt bei jedem Request hinzu, ersetzt oder ergänzt ihn.
Phasen: prompt. Bearbeitet Inhalte: ja.
Einstellungen
Modi
- inject
- override
- decorator
Fügt eine System-Nachricht nur hinzu, wenn noch keine existiert. Vorhandene System-Prompts bleiben unverändert.Verhalten:
- Request hat keinen System-Prompt → einer wird hinzugefügt
- Request hat bereits einen System-Prompt → keine Änderung
llm_based_altering
Schreibt den Text ausgewählter Nachrichtenrollen um, indem ein Hilfsmodell
aufgerufen wird. In der Prompt-Phase schreibt es den Request um, in der
Response-Phase die Antwort des Assistenten (wenn roles den Wert assistant
enthält). Das ist nützlich für die Anonymisierung personenbezogener Daten (PII)
und andere inhaltserhaltende Umformulierungen.
Der Standard-prompt ist vom Guardrail data_anonymization von LiteLLM
abgeleitet, sodass bereits eine minimale Konfiguration als anonymisierender
Vorverarbeitungsschritt wirkt.
Phasen: prompt, response. Bearbeitet Inhalte: ja.
Einstellungen
Umformulierungen laufen prozessintern über den normalen übersetzten
Request-Pfad, sodass Workflow-Auswahl, Failover, Nutzungserfassung, Audit und
Cache-Verhalten weiterhin gelten. Der interne Request verwendet:
- Pfad:
/v1/chat/completions - User Path:
{guardrail.user_path or caller user path}/guardrails/{guardrail name} - Request-Ursprung:
plugin
fail_mode entscheidet: closed lehnt den Request ab,
open fährt mit dem Originaltext fort.
Beispiel
string_replace
Ersetzt, markiert oder blockiert Text, der auf eine Liste literaler Regeln oder
regulärer Ausdrücke passt. Funktioniert auf Prompts, Responses und Streams.
Regeln passen in jedem Modus nur innerhalb eines Text-Parts (eines Content-Parts
oder eines Tool-Ergebnis-Parts); Text, der über zwei Parts verteilt ist, wird
nicht erkannt.
Phasen: prompt, response, stream. Bearbeitet Inhalte: ja.
Einstellungen
In der Stream-Phase transformieren
replace und warn Events im laufenden
Betrieb mit dem konfigurierten Lookbehind. block und respond puffern den
gesamten Stream, damit vor der Entscheidung nichts nach außen dringt – auf
Kosten einer Verzögerung des ersten Tokens, bis die Response vollständig ist.
Beispiel
tag_replace
Ersetzt Platzhalter {{gomodel.<tag>}} im Prompt-Text unmittelbar vor dem
Provider-Aufruf durch Werte des aktuellen Requests. Damit können Sie dem Modell
mitteilen, als welches Modell es läuft oder welches Datum heute ist, ohne dass
der Client diese Angaben sendet. Es lässt sich gut mit system_prompt
kombinieren: Schreiben Sie die Tags in den System-Prompt und führen Sie
tag_replace mit einem späteren order-Wert aus.
Phasen: prompt. Bearbeitet Inhalte: ja.
Tags
Leerzeichen innerhalb der geschweiften Klammern sind erlaubt. Unbekannte Tags
bleiben unverändert stehen.
Ein Tag ohne Wert für den Request, etwa
session_id ohne Session, wird leer.
Die Modell- und Provider-Tags benennen den zuerst ausgewählten Provider: Die
Prompt-Phase läuft nur einmal, daher erhält ein Failover-Versuch denselben Text.
Werte, die vom Aufrufer stammen, etwa user_path und session_id, werden so
eingefügt, wie sie gesendet wurden. Ein Request, in dessen Prompt ein Tag
expandiert wurde, wird nicht im Response-Cache gespeichert, da die Antwort
request-spezifische Werte wiederholen kann.
Einstellungen
Beispiel
header_edit
Setzt, ergänzt und entfernt HTTP-Header am Request, an der Client-Response und
am Upstream-Aufruf des Providers. Es bearbeitet nie Inhalte und kann sich daher
einen order-Wert mit einem bearbeitenden Guardrail teilen.
Phasen: prompt, response. Bearbeitet Inhalte: nein.
Einstellungen
Jeder Schlüssel ist eine Liste von Zeilen. Zeilen zum Setzen und Ergänzen haben die FormName: value; Zeilen zum Entfernen bestehen nur aus Name.
Leerzeilen und #-Kommentare werden ignoriert.
Header mit Zugangsdaten (
Authorization, X-Api-Key, Cookie, …) können nie
bearbeitet werden, und Namen, die secret oder token enthalten, können nicht
gesetzt werden.
Beispiel
llm_judge
Fragt ein Judge-Modell, ob der Prompt (oder die Response) gegen eine Richtlinie
verstößt, und blockiert, beantwortet oder markiert ihn je nach Urteil. Der Judge
ist entweder ein Chat-Modell oder ein Decision-Modell:
- Ein Chat-Modell muss mit genau einem JSON-Objekt
{"verdict":"allow"|"block","reason":"..."}antworten. Die Standardanweisungen verlangen das und weisen das Modell an, Anweisungen innerhalb des Inhalts zu ignorieren. - Einem Decision-Modell (Jev, Kev, den Decision-Modellen von OpenRouter oder einem OpenAI-Modell über die Decisions API) wird eine Ja-oder-Nein-Frage gestellt, und es liefert die Wahrscheinlichkeit für Ja. Es gibt keinen Text zu parsen, und berechnet werden nur Input-Tokens. Siehe Mit einem Decision-Modell urteilen.
Einstellungen
Identischer Text wird pro Request nur einmal beurteilt, sodass eine Instanz, die
sowohl in der Prompt- als auch in der Response-Phase läuft, denselben Inhalt
nicht doppelt berechnet. In der Stream-Phase wird der gesamte Stream gepuffert
und als vollständige Response beurteilt.
Mit einem Decision-Modell urteilen
Mit einem Decision-Modell sendet der Judge den beurteilten Text ohne Tags als Decisions-Input und stellt genau eine Prädikatfrage,decision_question. Er
verwendet weder prompt noch max_tokens oder temperature. Eine
Wahrscheinlichkeit größer oder gleich block_threshold ist ein Block-Urteil, und
action greift. Eine niedrigere Wahrscheinlichkeit lässt den Inhalt zu. Der Aufruf
durchläuft dasselbe Routing wie POST /v1/decisions:
virtuelle Modelle, Failover auf Ziele, die Decisions bedienen, den exakten
Response-Cache, Nutzung und Audit, unter dem User Path der Instanz.
Jedes Urteil erfasst die Wahrscheinlichkeit im Decision-Detail (probability),
und die Instanz meldet sie als Histogramm
plugin_llm_judge_decision_probability. Nutzen Sie beides, um block_threshold
pro Richtlinie abzustimmen: Erhöhen Sie den Wert, um nur eindeutige Verstöße zu
blockieren, oder senken Sie ihn, um mehr Grenzfälle zu erfassen.
engine: auto erkennt reine Decision-Modelle anhand des Modellkatalogs. Ein
OpenAI-Modell mit Decisions-Unterstützung kann auch chatten, daher befragt auto
es per Chat. Setzen Sie engine: decision, um stattdessen seine Decisions API zu
verwenden.
Lassen Sie judge_images bei einem Judge, der nur Text liest, etwa einem
Kev-Server, ausgeschaltet: Mit Bildern schlägt jeder Aufruf fehl, und fail_mode
entscheidet. Gehostetes Jev liest Bilder, die als Base64-Data-URLs gesendet
werden. Ist judge_images eingeschaltet, wird auch ein Prompt beurteilt, der nur
ein Bild enthält; andernfalls wird er ohne Judge-Aufruf zugelassen.
max_tokens für einen Reasoning-Judge bemessen
Ein Reasoning-Judge-Modell verbraucht seine Completion für das Nachdenken, bevor
es irgendetwas schreibt: Ist die Obergrenze vorher erreicht, liefert der Judge
kein Urteil, und die Instanz setzt nichts durch – sie folgt stattdessen
on_unclear, das standardmäßig nur warnt. Die Standardobergrenze von 2048
lässt dafür Spielraum; nicht verbrauchte Tokens werden nie berechnet. Erhöhen
Sie den Wert daher eher weiter, statt ihn zu kürzen, wenn das Judge-Modell viel
Reasoning betreibt.
Ein Judge, der zu keinem Urteil kommt, wird getrennt von einer Antwort erfasst,
die zwar gegeben wurde, aber nicht geparst werden konnte:
Prüfen Sie nach dem Konfigurieren einer Instanz das Gateway-Log auf
judge returned no verdict, und setzen Sie on_unclear: block für eine
Richtlinie, die auch dann gelten muss, wenn der Judge nichts Verwertbares
liefert. Ein Judge-Aufruf, der vollständig fehlschlägt – Provider-Fehler,
Timeout –, ist kein unklares Urteil: Darüber entscheidet fail_mode, wie bei
jedem anderen Guardrail-Fehler.
Beispiel
presidio
Erkennt personenbezogene Daten mit einem
Presidio-Analyzer und anonymisiert,
markiert oder blockiert sie. Es wird nur der Analyzer-Dienst benötigt; GoModel
schreibt den Text selbst um und kann daher die Originalwerte wieder in die
Response einsetzen.
Einstellungen
Jeder Text-Part wird einzeln analysiert (je ein Analyzer-Aufruf, bis zu acht
gleichzeitig), sodass der Analyzer nie die gesamte Unterhaltung als einen Text
sieht und seine eigenen Limits pro Part gelten. Das Audit-Detail erfasst
Entitätstypen und Anzahlen, nie die Werte, und Fehlermeldungen des Analyzers
enthalten nie den übergebenen Text. Der Analyzer erhält den Text im Klartext.
Betreiben Sie ihn daher als Sidecar auf demselben Host oder erreichen Sie ihn
über
https:// oder ein privates Netzwerk.
In der Stream-Phase transformieren anonymize und warn Events im laufenden
Betrieb in Chunks von stream_chunk Zeichen mit stream_lookbehind Zeichen
Überlappung; wird mitten im Stream ein Typ aus block_entities gefunden, wird
der Stream abgebrochen, bevor dieser Chunk den Client erreicht. block und
respond puffern den gesamten Stream, damit vor der Entscheidung nichts nach
außen dringt.
Werte wiederherstellen
Mitrestore: true ersetzt die Prompt-Phase Werte durch nummerierte
Platzhalter und merkt sie sich für den Request; die Response- oder Stream-Phase
setzt die Werte dort wieder ein, wo das Modell einen Platzhalter wiederholt – in
Text, Reasoning (reasoning_content oder reasoning) und Tool-Call-Argumenten.
So sieht der Client seine eigenen Daten, der Provider dagegen nie. Setzen Sie
restore bei den Instanzen in beiden Phasen: Die Instanz in der Prompt-Phase
erfasst die Werte, die Instanz in der Response-Phase stellt sie wieder her.
Reasoning wird nur wiederhergestellt, nicht analysiert. Wiederhergestelltes
Reasoning, das ein Chat-Client im nächsten Turn zurücksendet
(reasoning_content, das DeepSeek bei Tool Calls verlangt), wird in der
Prompt-Phase wie der restliche Verlauf erneut anonymisiert. Signierte
Thinking-Blöcke von Anthropic werden separat übertragen und nie bearbeitet; bei
/v1/messages, wo der Client den Thinking-Text mit seiner Signatur zurücksendet,
behält das Anthropic-Thinking seine Platzhalter. Auch Reasoning-Items einer
/v1/responses-Ausgabe (Zusammenfassungen und Reasoning-Text) behalten die
Platzhalter: Clients geben sie unverändert in input wieder, sodass
wiederhergestellte Werte im nächsten Turn den Provider erreichen würden.
Die Instanz in der Prompt-Phase benötigt restore, um die Werte zu erfassen;
die wiederherstellende Instanz liest restore_tools und
restore_tools_exclude. restore_roles wird von beiden gelesen: Die Werte
einer Rolle werden wiederhergestellt, wenn jede Instanz, die restore_roles
setzt, diese Rolle aufführt, oder – wenn keine von beiden es setzt –, wenn die
Standardliste sie enthält.
Nur Werte aus den restore_roles (standardmäßig User-Nachrichten, frühere
Assistant-Turns und Tool-Ergebnisse) werden wieder eingesetzt; ein Wert aus
einer System- oder Developer-Nachricht bleibt ein Platzhalter, sodass ein
Benutzer das Modell nicht dazu bringen kann, ihn preiszugeben. Fügen Sie
system hinzu, wenn die System-Nachricht die eigenen Daten des Benutzers
enthält (den Benutzernamen oder gespeicherte Erinnerungen eines Chat-Frontends)
und jeder, der das Deployment nutzen kann, sie sehen darf. Ein Wert, den das
Modell selbst erzeugt hat, wird auf dem Weg nach außen weiterhin anonymisiert.
Solche Responses werden nicht in den Response-Cache
aufgenommen. Text in Platzhalterform, der bereits in der Unterhaltung steht,
etwa ein <PERSON_2>, das eine frühere Antwort zurückgebracht hat, bleibt
unverändert, und seine Nummer wird nie für einen neuen Wert wiederverwendet.
Platzhalter werden in jeder Groß-/Kleinschreibung (<Person_1>) sowie in
Markdown- oder HTML-maskierter Form (\<PERSON\_1\>, <PERSON_1>)
erkannt. Gestreamter Text, Reasoning und die Tool-Call-Argumente jedes Aufrufs
werden im laufenden Betrieb wiederhergestellt, jeweils als eigenes Fenster
unter stream_lookbehind, einschließlich Platzhaltern, deren spitze Klammern
der Provider maskiert hat (Gemini liefert \u003cPERSON_1\u003e).
Tool-Call-Argumente werden standardmäßig für jedes Tool wiederhergestellt. Ein
clientseitig ausgeführtes Tool, das seine Argumente an Dritte sendet, etwa eine
Websuche, sollte die Platzhalter behalten: Führen Sie es in
restore_tools_exclude auf, oder listen Sie in restore_tools nur die Tools
auf, die die Werte benötigen (Wissenssuche, Rückfragen an den Benutzer,
Dokumenterstellung).
Ein Markdown-Renderer, der HTML bereinigt, kann einen in der Antwort
verbliebenen Platzhalter ausblenden (einen, den das Modell erfunden hat, oder
einen aus dem System-Prompt). Setzen Sie placeholder_format: "[{entity}_{n}]",
damit sie sichtbar bleiben. Die Instanzen, die an einem Request arbeiten, teilen
sich die Platzhalter im Format der zuerst laufenden Instanz. Geben Sie ihnen
daher dasselbe Format.
Beispiel
Beispiele
Einzelner Sicherheits-Guardrail
Das einfachste Setup – jedem Request ein Sicherheitspräfix hinzufügen:Prüfungen parallel zu einem bearbeitenden Guardrail
Eine nicht bearbeitende Prüfung teilt sichorder 0 mit dem
System-Prompt-Editor und läuft nebenläufig zu ihm:
Sequenzielle Pipeline
Guardrails mit unterschiedlichenorder-Werten laufen nacheinander. Spätere
Gruppen sehen die Ausgabe der früheren:
Response-Phase: Secrets auf dem Weg nach außen schwärzen
Läuft auf der vollständigen Response, bevor sie den Client erreicht. Setzen Siefail_mode: open, wenn Ihnen eine ungeschwärzte Antwort lieber ist als ein 500,
falls der Guardrail selbst fehlschlägt.
Stream-Phase: Im laufenden Betrieb schwärzen und die gesamte Antwort beurteilen
Dieselbe Instanz kann in mehreren Phasen referenziert werden.mask-keys
transformiert gestreamte Chunks im laufenden Betrieb (64 Zeichen Lookbehind,
sodass ein über zwei Chunks verteilter Key trotzdem erkannt wird).
answer-judge benötigt die gesamte Antwort, puffert daher den Stream, und der
Client erhält ihn, sobald das Urteil vorliegt.
Zusammenspiel mit verschiedenen Endpunkten
Guardrails arbeiten intern auf einem einheitlichen Nachrichtenformat. Die Anpassung zwischen den API-spezifischen Request-Typen und diesem Format erfolgt automatisch:/v1/decisions und /v1/systemone führen nur die Prompt-Phase aus: Ihre
Antworten sind typisierte Werte statt Completions, daher werden Guardrails der
Response- und Stream-Phase dort übersprungen, mit einer Warnung pro Guardrail.
Bearbeitungen, die sie nicht aufnehmen können, etwa ein eingefügter
System-Prompt, werden verworfen.
Bei /v1/messages nimmt ein Request, auf dem ein Guardrail läuft, den
übersetzten Pfad (der native Passthrough wird übersprungen). Eine von einem
Guardrail abgeschnittene Response wird an OpenAI-kompatiblen Endpunkten mit
finish_reason: "content_filter" und an /v1/messages mit
stop_reason: "end_turn" gemeldet.
Guardrails und der Response-Cache
Der Response-Cache speichert die Antwort, die die Response- und Stream-Ketten bereits erzeugt haben, und ein Cache-Treffer spielt sie ab, ohne diese Ketten erneut auszuführen. Beide Cache-Ebenen verwenden daher die Guardrail-Kette, zu der der Request aufgelöst wird, über alle drei Phasen hinweg als Teil des Keys:- Wird ein Step bearbeitet, hinzugefügt oder entfernt, sind alle unter der alten Kette gespeicherten Einträge nicht mehr erreichbar; der nächste Request durchläuft die vollständige Pipeline und speichert seinen eigenen Eintrag.
- Zwei Workflows mit unterschiedlichen Ketten teilen sich nie Einträge, sodass ein Tenant, dessen Workflow auf dem Weg nach außen schwärzt, nie die ungeschwärzte Antwort eines anderen Tenants erhält.
- Eine blockierte Response ist nicht cachebar, daher kann ein blockierender Guardrail nie durch einen Cache-Treffer umgangen werden.
restore unter presidio).
Da die Response-Kette bei einem Cache-Treffer nicht läuft, erfasst der
Audit-Eintrag für einen Treffer nur die Ergebnisse der Prompt-Phase sowie den
Cache-Typ.
Entscheidungen, Fehler und Ablehnung
Ein blockierter Request erreicht nie den Provider; eine blockierte Response
erreicht nie den Client. Unter Plugins
erfahren Sie, wie Entscheidungen zusammengeführt werden, wenn mehrere Guardrails
mit demselben
order-Wert laufen.
Jedes Ergebnis, auch ein stilles Zulassen, wird im Audit-Eintrag des Requests
unter data.guardrails erfasst – mit Phase, Step, Entscheidung, der Angabe, ob
der Guardrail den Request oder die Response bearbeitet hat, und wie er
fehlgeschlagen ist. Das Dashboard färbt die Guardrail-Steps im Workflow-Diagramm
eines Audit-Eintrags danach ein: grün, wenn der Step bestanden oder bearbeitet
hat; gelb bei einer Warnung oder einem Fail-open-Fehler; rot bei einem
Blockieren, einer Antwort oder einem Fail-closed-Fehler; abgedunkelt, wenn der
Step nie gelaufen ist. Die Felder finden Sie unter
Plugins.