

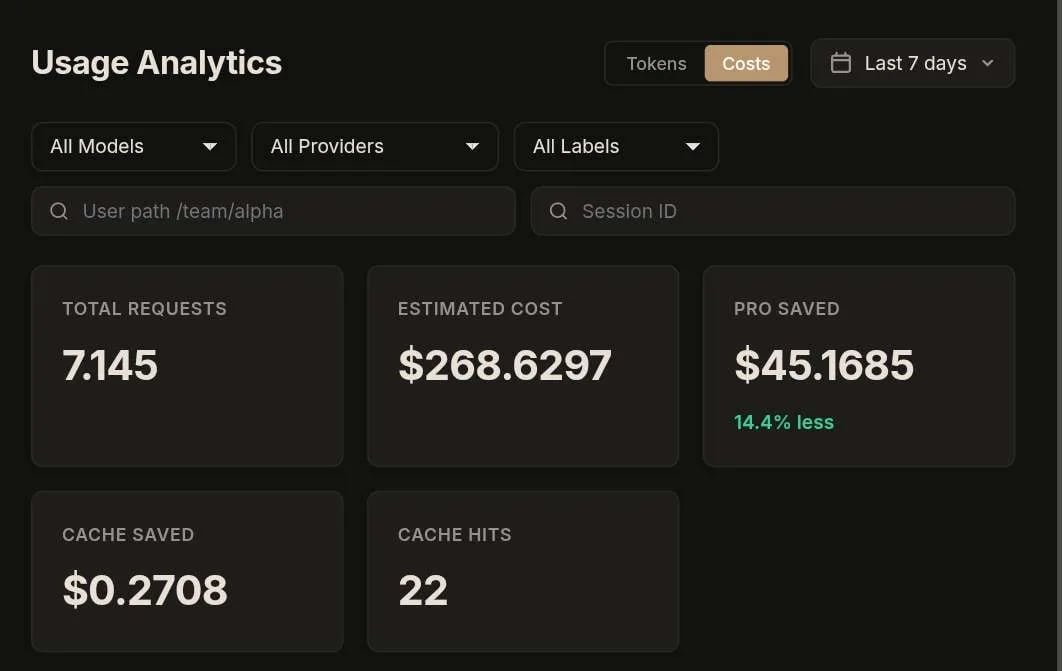
Seite „Usage“ im Dashboard: Pro-Einsparungen über sieben Tage Produktions-Traffic.
In der Produktion bewährt
Die Prompt-Komprimierung wurde mit Milliarden von Produktions-Tokens in agentischen Coding-, Chat- und Tool-lastigen Workloads erprobt.- Verlustfrei. Die Komprimierung ersetzt nur Inhalte, die das Modell im selben Request bereits gesehen hat, durch einen Verweis darauf, oder kodiert strukturierte Daten umkehrbar neu. Das Modell erhält dieselben Informationen; nichts wird zusammengefasst oder weggelassen. Die einzige verlustbehaftete Option, das Kürzen von Tool-Ergebnissen, ist eine separate Richtlinie, die standardmäßig ausgeschaltet ist.
- Keine Beeinträchtigung des Prompt-Caches. Da das zuvor gesendete Präfix einer Session Byte für Byte wiederholt wird und nur neue Nachrichten umgeschrieben werden, treffen die Prompt-Caches der Provider über mehrere Turns hinweg weiterhin. Tester beobachteten sogar eine Steigerung der Prompt-Cache-Treffer um etwa 2 %, da kürzere, stabilere Requests besser in den Cache passen – was zusätzliche Einsparungen zur eigentlichen Komprimierung bringt.
- Echte Einsparungen von 2 %–20 % der Input-Tokens bei unseren Testern, je nach Anwendungsfall. Agenten, die Dateien erneut lesen, Tool-Ausgaben wiederholen oder lange Verläufe mitführen, liegen am oberen Ende dieser Spanne; kurzer, nicht repetitiver Chat liegt am unteren Ende, wo der Kompressor Requests einfach unverändert weiterleitet.
- Volle Kontrolle. Wählen Sie die Stufe pro Gateway oder pro Request, schließen Sie
Modelle per Glob aus, schützen Sie bestehende Verläufe mit
new_messages_only, behalten Sie Quellcode wortgetreu bei und prüfen Sie jede Umschreibung über Response-Header, Audit-Revisionen und Metriken.
Übersicht
Die Prompt-Komprimierung schreibt unterstützte Inferenz-Requests um, bevor sie den Provider erreichen. Sie reduziert wiederholten oder strukturellen Kontext und erhält dabei die Nicht-Text-Struktur des Requests. Unterstützt werdenPOST /v1/chat/completions, POST /v1/messages und
POST /v1/responses. Argumente von Tool-Aufrufen, Nicht-Text-Teile und unbekannte JSON-Felder
bleiben unverändert. Reasoning-Elemente von Responses werden immer unverändert
wiederholt, da die Responses API sie zusammen mit Function Calls verlangen kann.
Die Standardrichtlinie high kombiniert die Deduplizierung von Zeilenfolgen mit Normalisierung:
- Zeilennummern-Spalten aus Dateilesevorgängen werden zu einem kompakten Bereichs-Header
- wiederholtes Chat-Completions-Reasoning wird entfernt, wenn dies sicher möglich ist
- bekannte Hüllen von Tool-Ergebnissen, Suchergebnisse, Logs, JSON und Unified Diffs werden inhaltsbezogen normalisiert
- lohnende homogene JSON-Arrays und strukturierte Logs verwenden umkehrbare, selbstbeschreibende Kodierungen
new_messages_only, wenn das Gateway einer Unterhaltung beitreten kann, deren
Präfix es nicht beobachtet hat.
Komprimierung konfigurieren
Setzen Sie
PRO_COMPRESSION_LEVEL=none, um die Komprimierung für das gesamte
Gateway zu deaktivieren. Für einen einzelnen Request senden Sie:
none umgehen das Parsen des Request-Bodys, sodass
der Request unverändert weitergeleitet wird.
Komprimierung prüfen
Komprimierte Responses enthalten die geschätzte Einsparung und die Anzahl der ersetzten doppelten Blöcke:LOGGING_LOG_BODIES=true gesetzt ist. Prometheus-Metriken verwenden das
Präfix gomodel_pro_compression_, und die Seite „Usage“ im Dashboard zeigt die Pro-Einsparungen
in Tokens oder Kosten.