

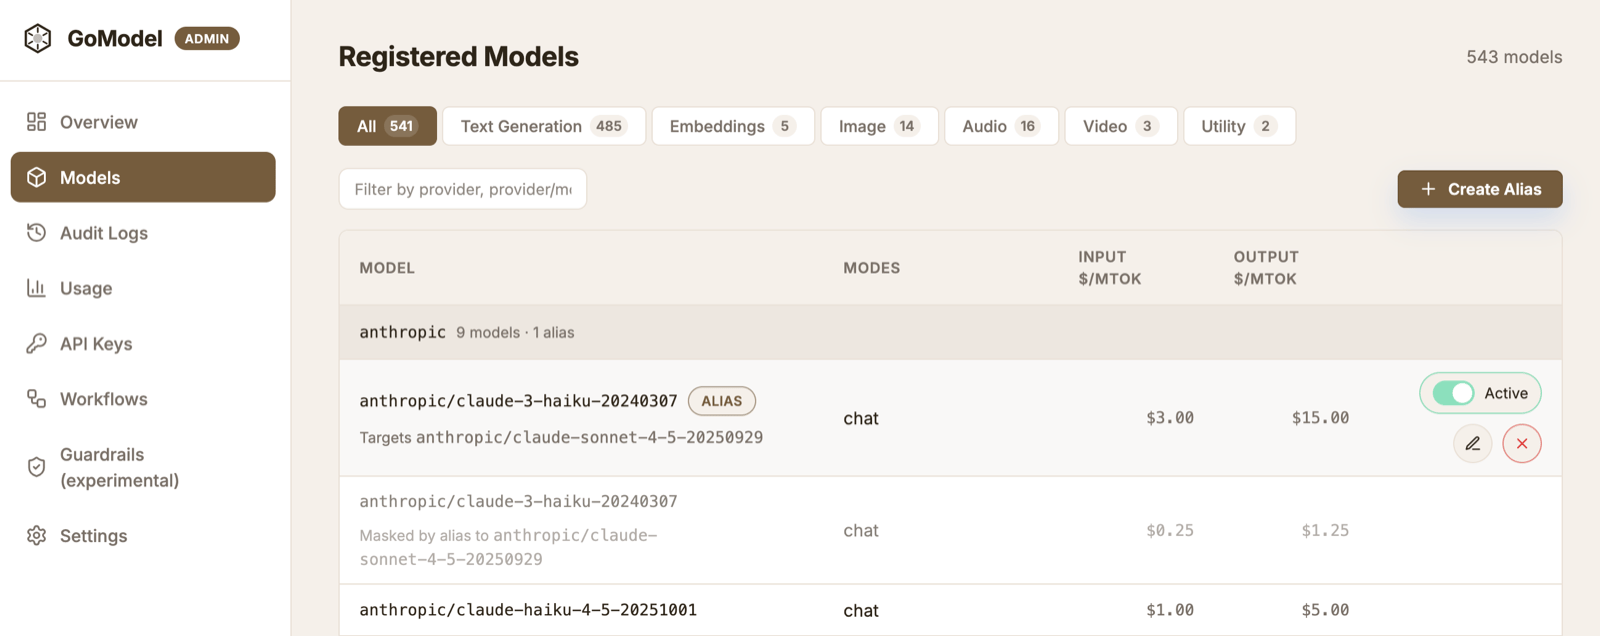
Was virtuelle Modelle leisten
Ein virtuelles Modell ist ein Modell, das Sie selbst definieren, statt eines, das ein Provider anbietet. GoModel bestimmt die Art danach, ob Sie ein Ziel angeben:- Ein Redirect (ein Alias) ist ein stabiler Name, der auf ein konkretes
Provider-Modell zeigt. Ihre Anwendung sendet den Namen im Feld
model, und GoModel löst ihn auf, bevor der Request an den Upstream gesendet wird. - Eine Zugriffsrichtlinie hat kein Ziel. Sie beschränkt einen vorhandenen
Modell-Selektor nach
user_path– oder deaktiviert ihn vollständig –, ohne einen neuen Namen hinzuzufügen. Zur Zugriffskontrolle siehe User Path.
Models -> New virtual model. Füllen Sie Target model aus, um einen
Redirect zu erstellen; lassen Sie das Feld leer, um eine Zugriffsrichtlinie für
den Selektor unter Source zu erstellen.
GoModel speichert keine leeren, wirkungslosen Zugriffsrichtlinien, unabhängig
davon, ob sie im Dashboard oder über die Admin API gespeichert werden. Hat eine
gespeicherte Richtlinie kein Ziel, keine User Paths, keine Beschreibung und kein
Slowdown, und entspricht ihr Aktivierungszustand dem geerbten bzw.
standardmäßigen Zugriffszustand, entfernt GoModel die gespeicherte Zeile. Eine
ansonsten leere Richtlinie bleibt erhalten, wenn diese Zeile noch einen
deaktivierten Standard oder eine geerbte User-Path-Beschränkung überschreibt.
Künstliche Modelllatenz hinzufügen
Setzen Sie Slowdown für ein konkretes Modell oder einen Redirect, um einen Anteil der gemessenen Inferenzzeit hinzuzufügen. Aktive Werte reichen von0.1
bis 10; zum Beispiel fügt 0.5 50 % hinzu, sodass eine Response, die upstream
2 Sekunden dauert, nach etwa 3 Sekunden zurückgegeben wird. Setzen Sie 0, um
Slowdown explizit zu deaktivieren, auch einen von einem konkreten Modell
geerbten. Wenn Sie das Feld leer lassen, bleibt die Einstellung unbestimmt.
Verzögerungen berücksichtigen den Abbruch von Requests.
Bei gestreamten Responses – SSE von Chat Completions und Responses API sowie die
Audio-Endpunkte – liest GoModel den Upstream
im Hintergrund vollständig aus und gibt jeden gelesenen Chunk auf der skalierten
Zeitachse frei. Dadurch bleibt das relative Chunk-Timing des Providers erhalten,
während sich verzögerte Chunks im Arbeitsspeicher ansammeln. Ein großer Faktor
bei einem langen oder umfangreichen Stream oder bei einer großen Audio-Response
kann daher erheblichen Speicher belegen; lassen Sie Slowdown im Produktivbetrieb
ungesetzt, wo es keinen Zweck erfüllt. Realtime-WebSocket-Sessions werden nicht
verlangsamt.
Wenn sowohl ein Alias als auch sein konkretes Ziel ein Slowdown haben, gilt der
Wert des Alias. Ein Alias ohne eigenen Wert erbt das Slowdown des ausgewählten
Zielmodells; setzen Sie den Alias auf 0, um diese Vererbung zu überschreiben.
Das gilt auch für per Load Balancing verteilte virtuelle Modelle, nachdem ein
Ziel ausgewählt wurde.
Der Rest dieser Seite behandelt Redirects.
Stabile Namen verwenden
Sie können Namen wieregular und smarter statt providerspezifischer
Modell-IDs bereitstellen.
regular->anthropic/claude-sonnet-4-6smarter->anthropic/claude-opus-4-6
Load Balancing über mehrere Modelle
Ein Redirect kann auf mehrere Zielmodelle zeigen und Requests auf diese verteilen. Fügen Sie im Editor mehr als ein Ziel hinzu (Add target) und wählen Sie eine Strategie:- Round-robin (Standard) verteilt Requests gleichmäßig reihum auf die Ziele.
Setzen Sie pro Ziel ein Gewicht (weight), um den Anteil zu verschieben –
ein Ziel mit Gewicht
2erhält doppelt so viel Traffic wie ein Ziel mit Gewicht1. - Lowest cost routet jeden Request an das günstigste derzeit verfügbare Ziel, sortiert nach dem Input- plus Output-Preis pro Token aus der Modell-Registry. Ein Ziel ohne Preisangaben in der Registry wird übersprungen, solange ein Ziel mit Preisen existiert; hat keines Preise, wird das erste aufgeführte Ziel verwendet.
- Failover routet immer an das erste derzeit verfügbare Ziel in der aufgeführten Reihenfolge: Die Ziele bilden eine Prioritätsliste, und nachrangige Einträge bedienen Requests nur, solange jeder Eintrag darüber nicht verfügbar ist oder fehlschlägt. Gewichte und Session Keeping gelten nicht.
- Adaptive (GoModel Pro) wählt das Ziel mit der besten beobachteten Latenz, Fehlerrate und dem besten Preis, nimmt rate-limitierte oder fehlschlagende Ziele zurück und hält eine Session bei dem Provider, dessen Prompt-Cache warm ist. Siehe Intelligentes Routing. In einem Open-Source-Build fällt die Strategie auf Round-robin zurück.
- Plugin (
strategy: plugin) überlässt die Auswahl einem geladenen Routing-Strategie-Plugin, das überstrategy_pluginbenannt und pro Redirect überstrategy_configkonfiguriert wird. Das eingebautecheapest_healthybevorzugt das günstigste (oder schnellste) Ziel, dessen jüngste Fehlerrate akzeptabel ist. Gewichte gelten nicht; schlägt das Plugin fehl oder fehlt es, fällt der Redirect auf gewichtetes Round-robin zurück.
user_path des
Requests nicht verwenden darf: Jede Strategie routet daran vorbei. Wenn Sie ein
Modell deaktivieren (zum Beispiel, während das Kontingent seines Providers
erschöpft ist), wird sein Traffic also auf die anderen Ziele verlagert, bis Sie
es wieder aktivieren. Sind alle verfügbaren Ziele deaktiviert oder verweigert,
schlägt der Request mit model_access_denied fehl; ist überhaupt kein Ziel
verfügbar (unbekanntes Modell, Provider ausgefallen), wird der Name wie jeder
andere Modellname aufgelöst, was meist in einem Model-not-found-Fehler endet.
Ein Request, der ein deaktiviertes Modell direkt nennt, schlägt weiterhin fehl.
Ein Redirect mit einem einzigen Ziel verhält sich genau wie ein einfacher Alias.
Unabhängig von der Strategie bilden die übrigen Ziele die Failover-Kette des
Redirects: Wenn das gewählte Ziel mit einem Fehler fehlschlägt, für den ein
Retry möglich ist, wird der Request gegen die anderen verfügbaren Ziele in der
aufgeführten Reihenfolge wiederholt. Die Checkbox Failover im Editor
(standardmäßig aktiviert; failover: false als Code) schaltet das für einen
Redirect ab, sodass ein fehlgeschlagener Request stattdessen mit dem Fehler
beantwortet wird; sie kann auch global oder über den Workflow des Requests
abgeschaltet werden. Unter Failover erfahren Sie, welche
Fehler einen Retry auslösen und wie Sie einem echten Modell durch Überlagern
eine Failover-Kette hinzufügen.
Requests, die zu einer erkannten Client-Session gehören, bleiben bei dem Ziel,
das die Session zuerst bedient hat (Session keeping, standardmäßig
aktiviert), sodass Konversationen den Prompt-Cache ihres Providers über mehrere
Runden hinweg warm halten. Deaktivieren Sie die Checkbox Session keeping im
Editor (oder setzen Sie session_affinity: false), um zustandsloses Balancing
wiederherzustellen – siehe Session Keeping.
smart mit der Round-robin-Strategie sowohl auf
openai/gpt-4o als auch auf anthropic/claude-sonnet-4-6, um die Last
aufzuteilen, oder mit der Kostenstrategie auf ein Premium- und ein günstiges
Modell, um immer das günstigere zu nehmen.
Ziele neu anordnen
Die Zielliste ist geordnet, und der Editor hält sie bearbeitbar: Ziehen Sie den Griff (☰) am linken Rand einer Zielzeile auf eine andere Zeile, um ihre Position zu ändern. Die Zeile, auf der Sie ablegen, wird nicht ersetzt – die gezogene Zeile rückt an ihre Position, und die Zeilen dazwischen verschieben sich. Tastaturbenutzer können den Griff fokussieren und mit ArrowUp / ArrowDown dieselbe Verschiebung vornehmen. Der Griff erscheint nur, wenn der Redirect mehr als ein Ziel hat, und jede Strategie profitiert davon: Bei Failover ist die Reihenfolge die Prioritätskette (Position1 wird zuerst versucht), bei den
Balancing-Strategien ist Position 1 der erste Platz in der Warteschlange.
Gewichte und explizite Provider-Pins bleiben beim Verschieben an ihrem Ziel.
Virtuelle Modelle verketten
Ein Redirect-Ziel kann statt eines konkreten Modells ein anderes virtuelles Modell nennen. Das innere virtuelle Modell wird zur Laufzeit des Requests aufgelöst, sodass seine Ziele, Gewichte und Strategie einmal definiert und überall wiederverwendet werden, wo es referenziert wird – keine doppelten Ziellisten, die auseinanderlaufen.- Die Kosten-Strategie bepreist einen verketteten Zweig mit dem günstigsten konkreten Modell, das derzeit dahinter verfügbar ist.
- Ein verkettetes virtuelles Modell, das deaktiviert ist oder kein verfügbares Ziel hat, wird wie ein nicht verfügbares Provider-Modell übersprungen.
- Nur
user_pathsundslowdowndes äußeren virtuellen Modells gelten für einen Request; der Scope des inneren wird nicht ausgewertet, wenn es über eine Kette erreicht wird. /v1/modelslistet einen verketteten Redirect mit den Metadaten seines ersten verfügbaren konkreten Modells auf.
config.yaml, Dashboard oder Admin API –, nach Namen
zugeordnet. team/cheap erreicht daher das gleichnamige virtuelle Modell, auch
wenn es wie provider/model aussieht. Setzen Sie provider explizit
({ provider: groq, model: llama-3.3-70b }), um ein Ziel unabhängig von einem
gleichnamigen virtuellen Modell an ein konkretes Modell zu binden.
Ein Redirect, der ein echtes Modell überlagert und dieses
Modell unter seinen eigenen Zielen aufführt (die Form, die die Seite Models
erstellt, wenn Sie einem Modell Fallbacks oder Balancing hinzufügen), umhüllt
das Modell, statt es zu ersetzen. Ein Alias oder jeder andere Redirect, der das
Modell nennt, verkettet sich in diese Hülle und erhält so dasselbe Balancing und
Failover wie ein direkter Request – mit einer Ausnahme: Die Fallback-Referenz
einer solchen Hülle auf ein anderes umhülltes Modell erreicht das Modell selbst,
nicht die Fallback-Liste der anderen Hülle. Dadurch können sich zwei Modelle
gegenseitig absichern, ohne einen Zyklus zu bilden, und ein Fallback zieht nicht
die Fallbacks des Fallbacks mit. Da eine reine Referenz auf ein umhülltes Modell
das Modell und nicht die Hülle benennt, kann die Hülle gelöscht werden, solange
solche Referenzen existieren – sie fallen dann einfach auf das konkrete Modell
zurück. Eine Überlagerung, die ihre Quelle nicht aufführt, ersetzt das Modell
und wird wie jedes andere virtuelle Modell durchlaufen: Referenzen verketten sich
in ihre Ziele, und sie kann nicht gelöscht oder umbenannt werden, bis diese neu
ausgerichtet sind.
Ketten müssen zyklenfrei sein (a -> b -> a wird mit ausgeschriebenem Zyklus
abgelehnt) und dürfen höchstens 8 virtuelle Modelle tief sein. Beide Regeln
werden beim Speichern im Dashboard und beim Start für deklarative Einträge
durchgesetzt. Ein Ziel muss beim Speichern existieren – erstellen Sie zuerst das
innere virtuelle Modell –, und ein virtuelles Modell, durch das andere verketten,
kann nicht gelöscht oder umbenannt werden, bis diese neu ausgerichtet sind.
Einen Redirect umbenennen oder neu ausrichten
Öffnen Sie einen Redirect im Dashboard und bearbeiten Sie sein Feld Source, um ihn umzubenennen. GoModel verschiebt die Definition in einem Schritt auf den neuen Namen – der alte Name wird nicht mehr aufgelöst, aktualisieren Sie also jede Anwendung, die ihn noch sendet. Das Umbenennen auf einen Namen, der bereits zu einem anderen virtuellen Modell gehört, wird abgelehnt; das Umbenennen auf den Namen eines konkreten Modells überlagert dieses Modell (siehe Ein Modell überlagern). Redirects, die ein Modell überlagern, lassen sich auf dieselbe Weise bearbeiten – verwenden Sie die Aktion Edit redirect in der Zeile des Modells. Als Code deklarierte virtuelle Modelle behalten ihresource fest in der Konfiguration;
benennen Sie sie um, indem Sie die Deklaration bearbeiten.
Virtuelle Modelle als Code definieren
Betreiber, die ihre Konfiguration als Infrastructure-as-Code verwalten, können virtuelle Modelle statt im Dashboard inconfig.yaml oder in der
Umgebungsvariable VIRTUAL_MODELS deklarieren. Deklarative Einträge werden beim
Start angewendet, überschreiben jede Zeile im Admin-Speicher mit derselben
source und werden im Dashboard schreibgeschützt angezeigt (mit dem Badge
Config). Bearbeiten Sie die Konfiguration, um sie zu ändern.
In config.yaml:
config.yaml mit passender source überschreibt:
source, ein einzelnes target (Kurzform) oder eine
targets-Liste, strategy (round_robin, cost oder failover),
session_affinity (Standardwert true; siehe
Session Keeping), failover (Standardwert
true; siehe Failover), user_paths, description,
slowdown (0 deaktiviert geerbtes Slowdown; aktive Faktoren reichen von 0.1
bis 10) und enabled.
Ein Ziel-model kann ein anderes deklariertes virtuelles Modell nennen (siehe
Virtuelle Modelle verketten).
Lassen Sie die Ziele leer, um eine Zugriffsrichtlinie für den source-Selektor
zu deklarieren. Eine ungültige Deklaration (unbekannte Strategie, fehlendes oder
selbstreferenzierendes Ziel, ein Kettenzyklus oder eine Kette, die tiefer als
8 virtuelle Modelle ist, oder ein Ziel-provider, der keinem konfigurierten
Provider entspricht – ein Tippfehler) lässt den Start mit einer eindeutigen
Fehlermeldung fehlschlagen, die die registrierten Provider-Namen auflistet.
Zwei tolerante Ausnahmen sorgen dafür, dass gültige Setups weiterhin starten:
- Ein Ziel-
provider, der unterproviders:deklariert ist, sich aber nicht registriert hat – typischerweise, weil seine Zugangsdaten in dieser Umgebung nicht gesetzt sind –, erzeugt nur eine Warnung im Log; das Ziel bleibt nicht verfügbar, bis die Zugangsdaten aufgelöst werden. Eine über mehrere Umgebungen geteilteconfig.yamlstartet so weiterhin überall. - Ob ein Ziel-Modell existiert, wird beim Start nie geprüft: Der Modellkatalog lädt asynchron, daher ist die Verfügbarkeit eine Frage der Laufzeit, und ein nicht verfügbares Ziel wird bei der Auflösung einfach übersprungen.
Standardmäßige Verfügbarkeit von Modellen
Jedes Provider-Modell ist verfügbar, sofern keinvirtual_models-Eintrag etwas
anderes festlegt. Um diesen Standard umzukehren, setzen Sie:
targets genügt – er wirkt als
reine Zugriffsregel (enabled: true, optional mit user_paths). Requests an
nicht verfügbare Modelle schlagen mit 400 model_access_denied fehl, und diese
Modelle erscheinen nicht in GET /v1/models. Ein Redirect wird anhand seines
eigenen enabled-Flags aufgelöst, sein Ziel wird aber wie ein direkter Aufruf
validiert: Geben Sie bei ausgeschaltetem Standard auch dem Zielmodell einen
eigenen Zugriffseintrag. Ist dieses Ziel zugleich die Quelle eines anderen
Redirects, verwenden Sie stattdessen eine providerweite oder modellweite
Richtlinie: Ein Zugriffseintrag für diese Quelle ersetzt dort einen im Dashboard
verwalteten Redirect.
Das ist nicht das Gegenteil von Nur Redirects bereitstellen:
Jene Einstellung ändert nur, was GET /v1/models auflistet, während der
Verfügbarkeitsstandard festlegt, welche Modelle Requests überhaupt aufrufen
dürfen.
Nur Redirects bereitstellen
Um Provider-Modelle inGET /v1/models auszublenden, setzen Sie:
/v1/models die aktivierten
Redirects statt der vollständigen Liste der Provider-Modelle zurück. Die
Einstellung ist auch in .env.template aufgeführt.
Reine Modell-IDs auflisten
Standardmäßig gibtGET /v1/models Provider-qualifizierte IDs wie
openai/gpt-5 zurück. Manche Clients prüfen das konfigurierte Modell gegen
diese Liste und kennen nur einfache Namen, sodass sie nie eine Übereinstimmung
finden. Um stattdessen reine IDs aufzulisten, setzen Sie:
owned_by enthält weiterhin den Provider-Namen. Requests mit einer
reinen Modell-ID funktionieren in beiden Modi gleich.
Einschränkung: Wenn zwei Provider dieselbe Modell-ID bereitstellen (zum Beispiel
gpt-5 sowohl bei openai als auch bei azure), wird nur der Provider
aufgelistet, an den ein nicht qualifizierter Request geroutet wird (der zuerst
registrierte). Um einen Namen an einen bestimmten Provider zu binden, fügen Sie
ein virtuelles Modell mit diesem Namen als Quelle hinzu:
Ein Modell überlagern
Ein Redirect kann ein Modell „überlagern“ (Shadowing), indem er denselben Namen wie ein vorhandenes Modell verwendet und auf ein anderes Ziel zeigt. So können Sie ein angefordertes Modell überschreiben, ohne den Anwendungscode zu ändern. Zum Beispiel:- Quelle:
anthropic/claude-opus-4-6 - Zielmodell:
anthropic/claude-sonnet-4-6
anthropic/claude-opus-4-6 senden, während
GoModel den Request an anthropic/claude-sonnet-4-6 routet.
A/B-Tests
Redirects eignen sich gut für kurze Modellexperimente. Richten Sie einen Redirect von einem Ziel auf ein anderes um und vergleichen Sie dann das Verhalten der Anwendung, die Latenz und die Nutzung. Richten Sie zum Beispielsmarter für einen Test auf Opus und für einen anderen
auf Sonnet. Sie können auch opus-4-6 mit sonnet-4-6 überlagern, um zu
prüfen, ob derselbe Ablauf in der Anwendung weiterhin funktioniert.