

Übersicht
Rate-Limits begrenzen die Request-Rate, die Token-Rate und die Anzahl gleichzeitig laufender Requests. Jede Regel hat einen Scope, der festlegt, was sie schützt:- User Path (Kontrolle der Verbraucher) – z. B. darf
/team/alpha100Requests pro Minute senden,50,000Tokens pro Minute verbrauchen und10Requests gleichzeitig laufen lassen, und zwar über alles unterhalb dieses Pfads hinweg. - Provider (Schutz des Upstreams) – z. B. erhält der Provider
openaihöchstens500Requests pro Minute über alle Verbraucher und Modelle hinweg, sodass das Gateway Ihr Provider-Kontingent nie überschreitet. - Modell – z. B. darf
openai/gpt-4o90,000Tokens pro Minute verbrauchen; eine reine ID wiegpt-4obegrenzt das Modell über alle Provider hinweg.
429 mit einem Fehler im OpenAI-Format, einem
genauen Retry-After-Header und x-ratelimit-*-Headern – ein Modellwechsel
würde nicht helfen, denn der Verbraucher ist das Subjekt. Ein ausgelasteter
Provider oder ein ausgelastetes Modell wird dagegen wie ein nicht
verfügbares Ziel behandelt: Load Balancing und Failover virtueller Modelle
umgehen es, solange ein anderes Ziel Kapazität hat, und erst wenn kein
brauchbares Ziel mehr übrig ist, erhält der Client 429.
Limits gelten für alle Modell-Endpunkte: Chat Completions, Responses, Messages,
Embeddings, Audio, Passthrough, Realtime-Sessions und das Einreichen von
Batches.
Verwenden Sie Rate-Limits zur Traffic-Steuerung und Budgets zur
Ausgabenkontrolle: Budgets begrenzen Dollarbeträge über Stunden bis Monate
anhand dauerhaft gespeicherter Nutzungsdaten, Rate-Limits begrenzen die
Request- und Token-Geschwindigkeit über Sekunden bis zu einem Tag mit schnellen
In-Memory-Zählern.
Rate-Limits aktivieren
Rate-Limits sind standardmäßig aktiviert und kosten nichts, solange keine Regeln existieren:max_tokens) werden aus Nutzungsdaten gezählt und erfordern
daher die Nutzungserfassung:
Rate-Limits erstellen
Im Dashboard: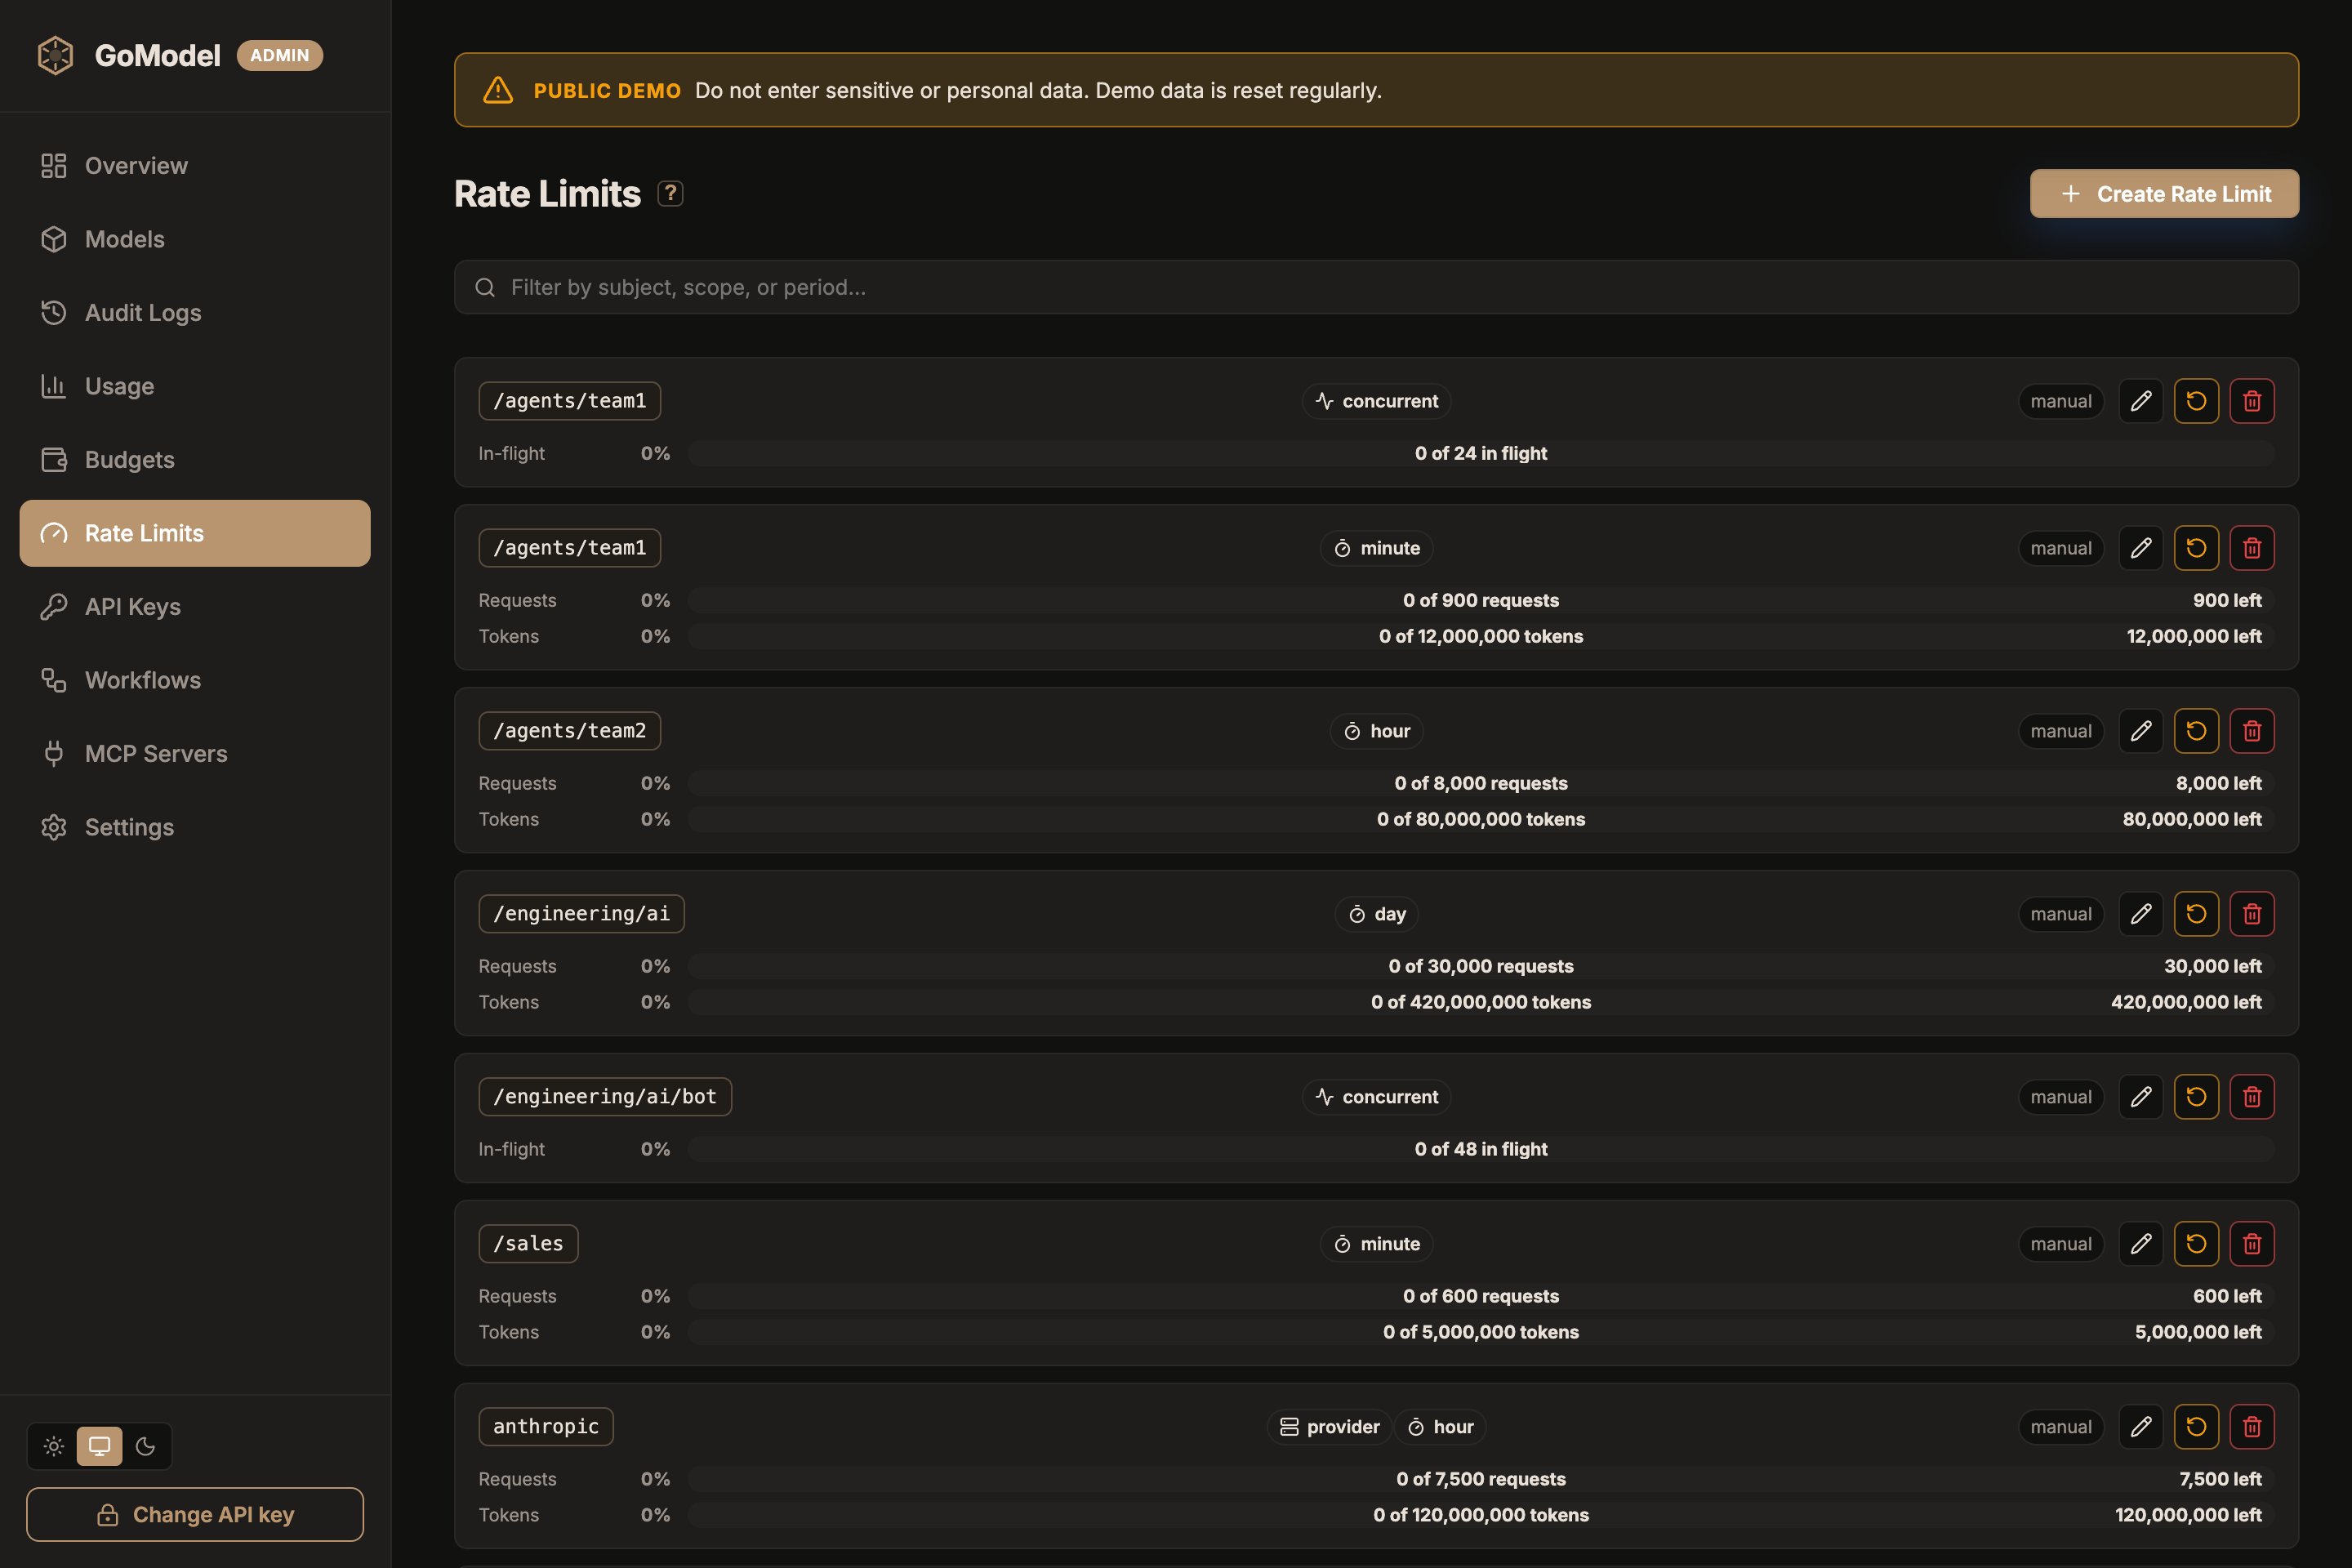
manual
gekennzeichnet. Aus YAML oder Umgebungsvariablen geladene Regeln werden als
config gekennzeichnet und sind im Dashboard schreibgeschützt. Jede Zeile
zeigt die Live-Nutzung im Verhältnis zum Limit; das Reset-Symbol setzt nur die
Zähler dieser Regel zurück, und das Papierkorb-Symbol löscht die Regel (was sie
ebenfalls zurücksetzt).
Die Seite Models hat in jeder Modellzeile und jeder Provider-Kopfzeile eine
Gauge-Schaltfläche, die dieselben Limits für dieses Subjekt im Kontext öffnet:
die eigenen Regeln des Modells, die Provider-Regeln, die es mitnutzt, und die
globalen Regeln (Root-User-Path) – jeweils mit Live-Nutzung – sowie Aktionen zum
Hinzufügen und Bearbeiten.
Wenn Sie Scope, Subjekt oder Zeitraum einer Regel bearbeiten, wird sie
verschoben: Die Regel wird unter dem neuen Key neu angelegt, und ihre
Live-Zähler beginnen von vorn. Wenn Sie nur die Obergrenzen bearbeiten, bleiben
die Zähler erhalten.
Regeln aus YAML vorbelegen:
SET_RATE_LIMIT_<PATH> (das Suffix wird genau wie bei SET_BUDGET_* auf einen
User Path abgebildet; __ trennt Pfadsegmente); Provider-Regeln verwenden
SET_PROVIDER_RATE_LIMIT_<NAME> (Unterstriche werden zu Bindestrichen, wie bei
den Umgebungsvariablen für Provider-Instanzen):
rpm/tpm pro Minute,
rph/tph pro Stunde, rpd/tpd pro Tag und concurrent für die Obergrenze
gleichzeitiger Requests. Für eigene Zeitfenster wird auch ein JSON-Array aus
Regelobjekten akzeptiert:
Eigene Zeitfenster verwenden direkt
period_seconds.
Wie Abgleich und Zählung funktionieren
Regelpfade gelten genau wie bei Budgets für den konfigurierten Pfad und alle darunterliegenden Pfade: Eine Regel auf/team trifft auf /team/app zu, aber
nicht auf /team-alpha. Eine Regel auf / gilt für den gesamten Traffic.
Provider-Regeln werden anhand des Namens der aufgelösten Provider-Instanz
abgeglichen. Modellregeln werden mit dem ausgeführten Modell abgeglichen: Ein
Subjekt mit Provider-Angabe (openai/gpt-4o) deckt das Modell eines Providers
ab, ein reines Subjekt (gpt-4o) deckt dieses Modell bei jedem Provider ab.
Der Abgleich ignoriert Groß-/Kleinschreibung, und die Regel behält die
Schreibweise bei, mit der Sie sie angelegt haben – eine Regel auf den Provider
openai-EU wird als openai-EU aufgeführt und gemeldet, trifft aber auf die
Route unabhängig von deren Schreibweise zu.
Eine Regel besitzt einen gemeinsamen Zähler für ihr gesamtes Subjekt. Eine
Regel mit 100 rpm auf /team erlaubt insgesamt 100 Requests pro Minute für
alles unterhalb von /team; eine Regel mit 500 rpm auf den Provider openai
teilen sich alle Verbraucher und Modelle, die dorthin geroutet werden. Für
Limits pro Key binden Sie jeden verwalteten API-Key an einen eigenen User Path
und definieren dort Regeln.
Dynamische Rate-Limits pro untergeordnetem Pfad sind in GoModel Pro
verfügbar und erfordern das Lizenz-Entitlement
quota_templates. Ohne es
werden Schreibzugriffe über die Admin API mit 403
quota_templates_not_entitled abgelehnt, und per_child: true in der
Konfiguration bricht den Start ab – GoModel fällt nie unbemerkt auf einen
gemeinsamen Zähler für den Teilbaum zurück, da dies die Semantik der
Durchsetzung ändern würde.per_child: true in einem User-Path-Eintrag, um ihn zu einem
dynamischen Template zu machen. Jeder direkt untergeordnete Pfad besitzt dann
eigene Zähler: Mit einem Template auf /customers teilt sich
/customers/alice/app den Zähler von /customers/alice, während
/customers/bob einen eigenen erhält. Der Template-Pfad /customers selbst
trifft nicht zu. Provider- und Modellregeln können nicht pro untergeordnetem
Pfad gelten.
Die globale Admin-Liste zeigt ein per child-Template ohne irreführenden
Gesamtzähler. GET /v1/usage löst das Template für den User Path des
Aufrufers auf und gibt die Live-Zähler dieses untergeordneten Pfads zurück.
Das Zurücksetzen oder Löschen des Templates leert alle Request- und
Token-Fenster der untergeordneten Pfade für diese Definition; aktive
Concurrency-Slots werden ganz normal freigegeben, wenn ihre Requests
abgeschlossen sind.
Alle zutreffenden Regeln werden geprüft; das erste ausgeschöpfte Limit lehnt
den Request ab.
Provider- und Modell-Limits umgehen Auslastung
Ein ausgelasteter Provider oder ein ausgelastetes Modell verhält sich wie eines mit veraltetem Bestand:- Load Balancing virtueller Modelle überspringt das ausgelastete Ziel und
wählt das nächste verfügbare, sodass ein Alias mit mehreren Zielen weiter
bedient wird. Sind alle Ziele ausgelastet, löst der Alias trotzdem auf sein
erstes Ziel auf, damit der Client das ehrliche
429mitRetry-Aftererhält (oder Failover übernimmt) statt eines Fehlers „Modell nicht verfügbar“, und der Alias bleibt die ganze Zeit in/v1/modelsaufgeführt. - Die Failover-Kette übernimmt bei einer ausgelasteten primären Route: Der primäre Provider wird nie aufgerufen (er würde den Request bereitwillig bedienen und das Limit aushebeln), der Durchlauf über die übrigen Ziele der Weiterleitung beginnt sofort, und durch Rate-Limits ausgelastete Kandidaten werden dabei übersprungen.
- Direkte Requests ohne virtuelles Modell erhalten
429mit einem ehrlichenRetry-After– dieselbe Antwort, die der Provider selbst irgendwann geben würde, nur ohne den verschwendeten Upstream-Aufruf. Überschreitungen bei Verbrauchern (User Path) liefern immer429: Ein Zielwechsel kann sie nicht entschärfen.
- Request-Fenster verwenden eine Sliding-Window-Schätzung, sodass sich Bursts an Fenstergrenzen nicht verdoppeln können.
- Die Token-Nutzung wird nach Abschluss jeder Response gezählt (einschließlich Streams). Ein einzelner Request kann ein Token-Fenster überschreiten, bevor der Zähler aufholt – dasselbe Verhalten wie bei anderen Gateways, die Tokens aus Responses zählen.
- Treffer im Response-Cache werden vor der Durchsetzung ausgeliefert und zählen nicht.
- Eine Realtime-Session zählt als ein Request und belegt für die gesamte Session einen Concurrency-Slot. Eine Batch-Einreichung zählt als ein Request und belegt keinen Concurrency-Slot.
- Request- und Token-Fenster liegen für die Zulassung im Speicher und werden
etwa einmal pro Sekunde (und beim Herunterfahren) als Snapshot in den
konfigurierten Speicher geschrieben, sodass sie einen Neustart und
gomodel --reloadüberstehen. Concurrency-Zähler werden nicht persistiert: Nach einem Neustart läuft nichts. Bei N Replikaten liegt das effektive Limit weiterhin bei etwa dem N-Fachen des konfigurierten Werts – verwenden Sie Budgets für dauerhafte, instanzübergreifende Kontrolle. Passen Sie das Snapshot-Intervall mitRATE_LIMITS_FLUSH_INTERVALan (Sekunden; Standardwert1;0überspringt das periodische Schreiben, lädt aber weiterhin beim Start und schreibt beim geordneten Herunterfahren).
Verhalten gegenüber Clients
Requests über einem Limit erhalten:429 und einem Retry-After-Header, der die Sekunden angibt, bis
ein Retry im Sliding Window tatsächlich zugelassen würde (was über die nächste
Fenstergrenze hinausreichen kann). OpenAI-SDKs warten bei dieser Form
automatisch ab (Backoff).
Die Überschreitung enthält außerdem die x-ratelimit-*-Header für das
erreichte Limit: limit/remaining/reset für ein Request- oder
Token-Fenster. Eine Concurrency-Überschreitung sendet
x-ratelimit-limit-requests und x-ratelimit-remaining-requests (immer 0),
aber kein x-ratelimit-reset-requests: Ein Zähler für laufende Requests hat
kein Fenster, das zurückgesetzt wird – ein Slot wird frei, wenn ein Request
abgeschlossen ist, und genau das schätzt Retry-After.
Erfolgreiche Responses auf begrenzten Pfaden enthalten Header im OpenAI-Stil
aus der zutreffenden Regel mit der stärksten Einschränkung:
Admin API
user_path ist eine Kurzform für
"scope": "user_path", "subject": ...):
POST /admin/rate-limits/reset-one mit
{"scope": ..., "subject": ..., "period": ...}) oder für alle Regeln
(POST /admin/rate-limits/reset mit {"confirmation": "reset"}) zurück. Das
Bearbeiten einer Regel setzt ihre Zähler nie zurück, das Löschen schon.
Die Liste der Endpunkte finden Sie unter
Admin-Endpunkte.