

概览
护栏是 插件 的一个具名、已配置的实例。 护栏在每个引用它的 工作流 中运行,处于以下三个阶段之一:- prompt:路由之后、请求到达提供商之前
- response:作用于完整响应,在其到达客户端之前
- stream:作用于每个流式事件(或作用于缓冲后的整个流,取决于插件)
/v1/responses 上,stream 阶段的护栏可能会丢弃、合并或拆分事件,因此 GoModel 会对交付的事件重新编号:sequence_number 仍从 0
开始且不留空隙,一直到终止事件 response.completed(流被截断时为 response.incomplete
/ response.failed)。
护栏适用于所有基于文本的端点:
/v1/chat/completions/v1/responses/v1/messages/v1/decisions和/v1/systemone,仅 prompt 阶段(参见 不同端点下的工作方式)
针对图像、TTS、STT 和视频模型的护栏计划作为独立系统提供,不在本文讨论范围内。
快速开始
在config/config.yaml 中添加 guardrails 配置段:
在控制台中管理
护栏定义也可以在管理控制台中创建和编辑,而不必使用config.yaml——适合在无需重新部署的情况下迭代规则,或供不直接管理此仓库配置的运维人员使用。
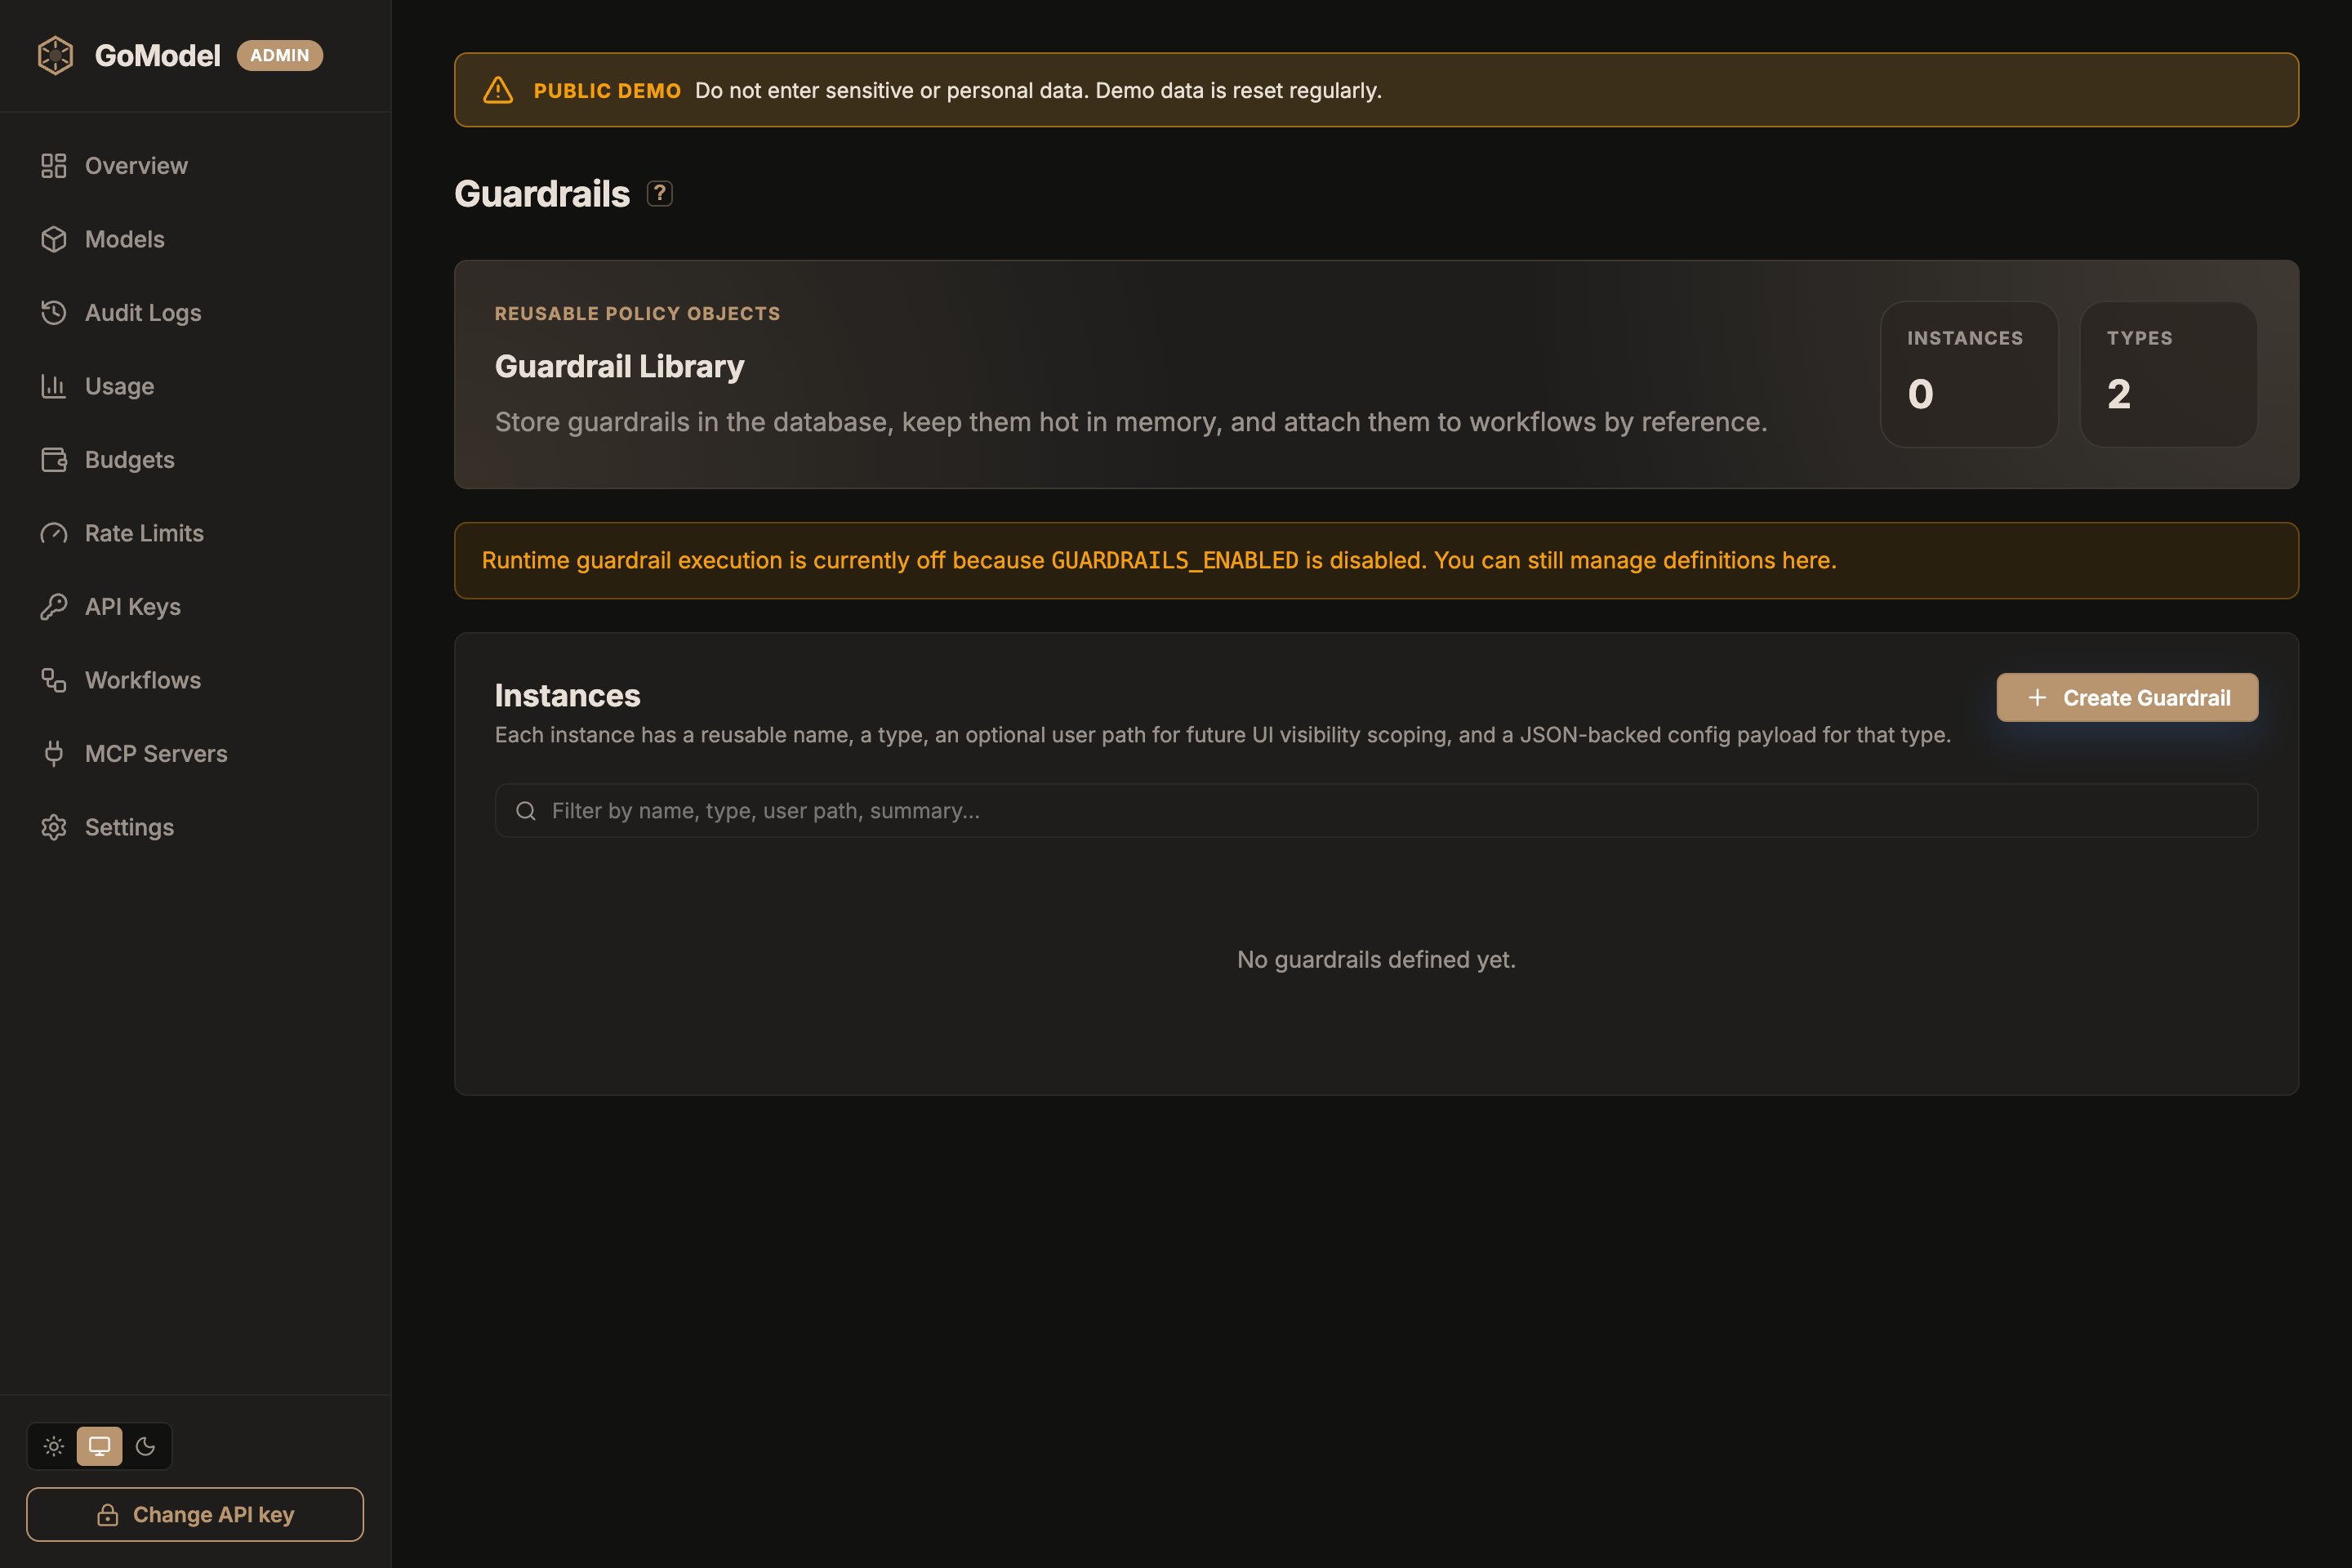
user_path,然后填写插件声明的表单。Advanced 部分包含失败模式和超时设置。config.yaml 中的条目会在启动时写入同一存储,并与其保持同步,因此在控制台创建的护栏和在配置中声明的护栏会并列显示。页面底部的 Plugins 列表显示每个已加载的插件类型及其钩子、来源和健康状态。并非所有插件都是护栏:
当插件的实例会对提示词、响应或流应用策略时,该插件会在其清单(manifest)中声明 Guardrail: true,控制台会用盾牌图标标记这类插件以及由其构建的实例。像
cheapest_healthy 这样的路由策略也列在同一页面上,但它不是护栏。
护栏在运行时是否执行仍取决于
GUARDRAILS_ENABLED。关闭该选项时,您仍可在该页面管理定义——只是它们暂不会作用于实际流量。工作原理
- 请求被映射为统一的
Prompt(包含带有稳定 ID 的 system、user、assistant 和 tool 消息) - 运行 prompt 链:每个护栏编辑提示词,或决定拦截、应答或警告
- 编辑结果被应用回原始请求,请求随后继续发往提供商
- 在任何内容到达客户端之前,response 链作用于完整响应(或 stream 链作用于流)
Exchange。同一个护栏在 /chat/completions、/responses 和 /messages 上的行为完全一致。
执行顺序
每个护栏都有一个order 值(即工作流步骤),用于控制其在所属阶段内的运行时机:
- 相同 order → 并行运行(并发)
- 不同 order → 顺序运行(升序)
system_prompt、llm_based_altering、
string_replace、presidio)不能与另一个编辑型护栏共用同一个 order;每个 order 只能有一个编辑者,但可以与任意数量的非编辑型检查(llm_judge、
header_edit)并列。当同一 order 上的多个护栏做出不同决定时,以最严格的决定为准:block > respond > warn >
allow。
配置
完整结构
system_prompt 和 llm_based_altering 也接受以类型命名的类型化块(system_prompt: / llm_based_altering:)来提供设置,如快速开始中所示。类型化块与 config: 等价;其他所有类型请使用 config:。
面向行的键(如 string_replace.rules 和
header_edit 的各个列表)既接受块标量(|),也接受字符串组成的 YAML 列表,后者会以换行符拼接。
环境变量
您无需编辑配置文件即可开关护栏:PLUGINS_ENABLED,默认关闭)。两者都关闭时,护栏端点和控制台页面均不可用。
规则字段
护栏类型
GoModel 内置六种类型。每种都是一个内置插件;下表列出了它们在config: 下和控制台表单中显示的配置键。
system_prompt
在每个请求上添加、替换或装饰系统提示词。
阶段: prompt。编辑内容: 是。
设置
模式
- inject
- override
- decorator
仅在不存在系统消息时添加一条系统消息。已有的系统提示词保持不变。行为:
- 请求中没有系统提示词 → 添加一条
- 请求中已有系统提示词 → 不做更改
llm_based_altering
通过调用辅助模型改写选定消息角色的文本。
在 prompt 阶段,它改写请求;在 response 阶段,它改写助手的回复(当 roles 包含 assistant 时)。这适用于 PII 匿名化以及其他保留内容含义的改写。
默认的 prompt 源自 LiteLLM 的 data_anonymization 护栏,因此最小配置即可作为匿名化预处理器使用。
阶段: prompt、response。编辑内容: 是。
设置
改写在进程内通过常规的翻译请求路径执行,因此工作流选择、故障转移、用量、审计和缓存行为依然适用。
内部请求使用:
- 路径:
/v1/chat/completions - 用户路径:
{guardrail.user_path or caller user path}/guardrails/{guardrail name} - 请求来源:
plugin
fail_mode 决定后续行为:closed 拒绝请求,open 使用原始文本继续。
示例
string_replace
对匹配一组字面量或正则表达式规则的文本进行替换、标记或拦截。适用于提示词、响应和流。在所有模式下,规则都只在单个文本部分(内容部分或工具结果部分)内匹配;
跨两个部分的文本不会被匹配。
阶段: prompt、response、stream。编辑内容: 是。
设置
在 stream 阶段,
replace 和 warn 使用配置的回看窗口在传输中转换事件。block 和 respond 会缓冲整个流,确保在做出决定前不泄露任何内容,代价是首 Token 会延迟到响应完成后才送达。
示例
tag_replace
在调用提供商之前,将提示词文本中的 {{gomodel.<tag>}} 占位符替换为当前请求的值。可用它告诉模型自己以哪个模型身份运行,或今天的日期,而无需客户端发送这些信息。它与 system_prompt 搭配效果很好:把标签放在系统提示词中,并在更靠后的 order 上运行
tag_replace。
阶段: prompt。编辑内容: 是。
标签
花括号内允许有空格。未知标签会保持原样。
对请求而言没有值的标签(例如没有会话时的
session_id)会变为空。模型和提供商标签指向第一个被选中的提供商:
prompt 阶段只运行一次,因此故障转移尝试会收到相同的文本。
来自调用方的值(如 user_path 和 session_id)会按原样插入。提示词中有标签被展开的请求不会存入响应缓存,因为回复中可能会复述请求特定的值。
设置
示例
header_edit
在请求、客户端响应和上游提供商调用上设置、添加和删除 HTTP Header。它从不编辑内容,因此可以与编辑型护栏共用同一个 order。
阶段: prompt、response。编辑内容: 否。
设置
每个键都是一个行列表。设置行和添加行的格式为Name: value;
删除行只写 Name。空行和 # 注释会被忽略。
凭据类 Header(
Authorization、X-Api-Key、Cookie 等)永远无法编辑,名称中包含 secret 或 token 的 Header 也无法设置。
示例
llm_judge
询问一个评判模型,提示词(或响应)是否违反策略,并根据裁决结果进行拦截、应答或标记。评判模型可以是聊天模型,也可以是决策模型:
- 聊天模型必须回复一个 JSON 对象
{"verdict":"allow"|"block","reason":"..."}。默认指令会要求模型这样做,并告诉模型忽略内容中的指令。 - 决策模型(Jev、Kev、OpenRouter 的决策模型,或通过 Decisions API 调用的 OpenAI 模型)会被提出一个“是或否”的问题,并返回“是”的概率。无需解析任何文本,且只按输入 Token 计费。参阅使用决策模型进行评判。
设置
相同的文本在每个请求中只评判一次,因此同时在 prompt 和 response 阶段运行的实例不会对相同内容重复计费。在 stream 阶段,整个流会被缓冲,并作为完整响应进行评判。
使用决策模型进行评判
使用决策模型时,评判会将被评判的文本直接作为 Decisions 输入发送(不加包裹标签),并提出一个谓词问题,即decision_question。它不使用 prompt、max_tokens 或 temperature。概率达到或超过
block_threshold 即为 block 裁决,并应用 action;概率较低则放行。该调用与
POST /v1/decisions 经过相同的路由:虚拟模型、故障转移到支持 Decisions 的目标、精确响应缓存、用量和审计,并归属于该实例的用户路径。
每个裁决都会在决策详情中记录概率(probability),实例还会将其上报为直方图
plugin_llm_judge_decision_probability。您可以据此按策略调整 block_threshold:调高它可只拦截明确的违规内容,调低它可捕获更多边界内容。
engine: auto 根据模型目录识别只回答决策的模型。支持 Decisions 的 OpenAI 模型同样可以聊天,因此 auto 会通过聊天方式询问它。如需改用其 Decisions API,请设置 engine: decision。
对于只读取文本的评判模型(例如 Kev 服务器),请保持 judge_images 关闭:如果带有图像,每次调用都会失败,并由 fail_mode 决定后续行为。托管的 Jev 可以读取以 base64 data URL 形式发送的图像。开启 judge_images 后,只包含图像的提示词也会被评判;否则,这类提示词会直接放行,不调用评判模型。
为推理型评判模型设置 max_tokens
推理型评判模型在输出任何内容之前,会先把补全额度花在思考上:如果上限先被耗尽,评判模型就不会返回裁决,实例也就无法执行任何策略——转而遵循 on_unclear,而它默认只发出警告。默认上限 2048 为此留出了余量;未用完的 Token 从不计费,因此当评判模型推理较多时,应进一步调高上限,而不是削减它。
未得出裁决的情况会与“有回复但无法解析”的情况分开记录:
配置实例后,请检查网关日志中是否有
judge returned no verdict;对于即使评判模型未给出可用回答也必须生效的策略,请设置 on_unclear: block。评判调用直接失败(提供商错误、超时)不属于裁决不明确:与其他护栏失败一样,由 fail_mode 决定。
示例
presidio
使用 Presidio
分析器检测个人数据,并对其进行匿名化、标记或拦截。只需要分析器服务;GoModel 自行改写文本,因此可以把原始值还原到响应中。
设置
每个文本部分都会单独分析(每部分调用一次分析器,最多同时进行八个),因此分析器从不会把整段对话视为一个文本,分析器自身的限制按部分生效。审计详情记录实体类型和数量,从不记录值本身,分析器返回的错误也从不携带传给它的文本。分析器接收的是明文,因此请将其作为 Sidecar 运行在同一主机上,或通过
https:// 或私有网络访问。
在 stream 阶段,anonymize 和 warn 以 stream_chunk 个字符为一块、以 stream_lookbehind 为重叠区,在传输中转换事件;如果在流的中途发现
block_entities 中的类型,会在该分块到达客户端之前截断流。block 和 respond 会缓冲整个流,确保在做出决定前不泄露任何内容。
还原值
设置restore: true 后,prompt 阶段会用带编号的占位符替换值,并在该请求范围内记住它们;response 或 stream 阶段会在模型复述占位符的位置还原这些值,覆盖文本、推理内容(reasoning_content 或 reasoning)以及工具调用参数,因此客户端看到的是自己的数据,而提供商始终看不到。请在两个阶段的实例上都设置 restore:
prompt 阶段的实例记录值,response 阶段的实例还原值。推理内容只会被还原,不会被分析。聊天客户端在下一轮发回的已还原推理内容(reasoning_content,DeepSeek 在工具调用时要求提供)会像其余历史记录一样,在 prompt 阶段再次被匿名化。带签名的 Anthropic
思考块单独传输,从不被编辑;在 /v1/messages 上,客户端会连同签名一起发回思考文本,因此 Anthropic
思考内容保留占位符。/v1/responses 输出中的推理条目(摘要和推理文本)同样保留占位符:客户端会在
input 中原样回放它们,如果还原了值,这些值会在下一轮到达提供商。
prompt 阶段的实例需要 restore 才能记录值;执行还原的实例读取 restore_tools 和 restore_tools_exclude。
restore_roles 两者都会读取:当所有设置了 restore_roles 的实例都列出了某个角色时,或者两者都未设置而默认列表包含该角色时,该角色的值才会被还原。
只有来自 restore_roles(默认为用户消息、之前的助手轮次和工具结果)的值会被还原;来自 system 或 developer
消息的值仍保留为占位符,因此用户无法诱使模型泄露它。当系统消息包含用户自己的数据(例如聊天前端中的用户名或记忆),并且任何能使用该部署的人都可以看到这些数据时,请加入
system。模型自行生成的值在输出时仍会被匿名化。此类响应不会进入 响应缓存。对话中已经存在的、形似占位符的文本(例如之前回复中带回的 <PERSON_2>)会保持原样,其编号也不会被新值复用。
占位符在任意大小写形式下(<Person_1>)以及经过 Markdown
或 HTML 转义时(\<PERSON\_1\>、<PERSON_1>)都能被识别。流式文本、推理内容以及每次调用的工具调用参数都会在传输中被还原,各自使用 stream_lookbehind 下的独立窗口,包括尖括号被提供商转义的占位符(Gemini 返回
\u003cPERSON_1\u003e)。
默认情况下,所有工具的工具调用参数都会被还原。会把参数发送给第三方的客户端工具(例如网页搜索)应保留占位符:将其列入 restore_tools_exclude,或者只在
restore_tools 中列出需要这些值的工具(知识检索、向用户提问、文档生成)。
会对 HTML 进行清洗的 Markdown 渲染器可能会隐藏回复中残留的占位符(模型自行编造的,或来自系统提示词的)。设置
placeholder_format: "[{entity}_{n}]" 可让它们保持可见。处理同一请求的多个实例共享占位符,格式以第一个运行的实例为准,因此请为它们设置相同的格式。
示例
示例
单个安全护栏
最简单的配置——为每个请求添加安全前缀:与编辑型护栏并行的检查
非编辑型检查与系统提示词编辑者共用 order0,并与其并发运行:
顺序流水线
order 不同的护栏依次运行。后面的组会看到前面组的输出:Response 阶段:在输出时遮盖密钥
在完整响应到达客户端之前运行。如果在护栏自身失败时,您宁愿返回未遮盖的回答也不愿返回 500,请设置fail_mode: open。
Stream 阶段:传输中遮盖并评判完整回答
同一个实例可以在多个阶段中被引用。mask-keys 在传输中转换流式分块(回看窗口为 64 个字符,因此跨两个分块的密钥仍能被捕获)。answer-judge 需要完整回答,因此它会缓冲流,客户端在裁决完成后才收到内容。
不同端点下的工作方式
护栏在内部基于统一的消息格式运行。各 API 特定的请求类型与该格式之间的适配会自动完成:/v1/decisions 和 /v1/systemone 只运行 prompt 阶段:它们的回答是类型化的值而不是补全,因此会跳过 response 和 stream 阶段的护栏,并为每个护栏输出一条警告。它们无法承载的编辑(例如注入的系统提示词)会被丢弃。
对于 /v1/messages,运行了任何护栏的请求都会走翻译路径(跳过原生透传)。被护栏截断的响应,在兼容 OpenAI 的端点上以
finish_reason: "content_filter" 报告,在 /v1/messages 上以 stop_reason: "end_turn" 报告。
护栏与响应缓存
响应缓存 存储的是 response 链和 stream 链已经处理后的回复,缓存命中时会直接回放,而不会再次运行这些链。因此,两个缓存层都以请求解析到的护栏链(涵盖全部三个阶段)作为键的一部分:- 编辑、添加或删除某个步骤后,所有存储在旧链下的条目都将无法命中;下一个请求会运行完整流水线,并存储自己的条目。
- 链不同的两个工作流永远不会共享条目,因此工作流会在输出时进行遮盖的租户,永远不会收到其他租户未经遮盖的回复。
- 被拦截的响应不可缓存,因此拦截型护栏永远不会因缓存命中而被跳过。
presidio 下的 restore)。
由于缓存命中时 response 链不会运行,命中请求的审计条目只记录 prompt 阶段的结果以及缓存类型。
决定、错误与拒绝
被拦截的请求永远不会到达提供商;被拦截的响应永远不会到达客户端。关于多个护栏在同一 order 运行时决定如何合并,请参见 插件。
每个结果(包括静默放行)都会记录在请求审计条目的
data.guardrails 下,包含阶段、步骤、决定、护栏是否编辑了请求或响应,以及失败方式。控制台据此为审计条目工作流图中的护栏步骤着色:
步骤通过或进行了编辑时为绿色,警告或 fail-open 错误为琥珀色,拦截、应答或 fail-closed 错误为红色,步骤从未运行时为灰暗色。字段说明参见 插件。