

概览
速率限制用于限制请求速率、Token 速率和进行中的并发数。每条规则都有一个作用域,决定它保护的对象:- 用户路径(使用方控制)——例如
/team/alpha每分钟可以发送100个请求、消耗50,000个 Token, 并同时保持10个进行中的请求,统计范围涵盖该路径下的所有内容。 - 提供商(上游保护)——例如在所有使用方和模型之间,每分钟最多向提供商
openai发送500个请求, 从而确保网关永远不会突破您的提供商配额。 - 模型——例如
openai/gpt-4o每分钟最多可消耗90,000个 Token;像gpt-4o这样的裸 ID 会在所有提供商上限制该模型。
429、OpenAI 格式的错误、准确的 Retry-After 响应头以及
x-ratelimit-* 响应头——切换模型无济于事,因为受限的是使用方本身。而饱和的提供商或模型则会被视为不可用的目标:
只要还有其他目标有余量,虚拟模型的负载均衡和故障转移就会绕开它;只有在不存在可用目标时,客户端才会收到 429。
限制适用于所有模型端点:Chat Completions、Responses、Messages、嵌入(Embeddings)、音频、透传、Realtime 会话以及批处理提交。
请使用速率限制进行流量控制,使用预算进行支出控制:预算基于持久化的用量记录,在数小时到数月的时间范围内限制金额;
速率限制使用快速的内存计数器,在数秒到一天的时间范围内限制请求和 Token 的速率。
启用速率限制
速率限制默认启用,在存在规则之前不会产生任何开销:max_tokens)基于用量记录计数,因此需要启用用量追踪:
创建速率限制
在控制台中: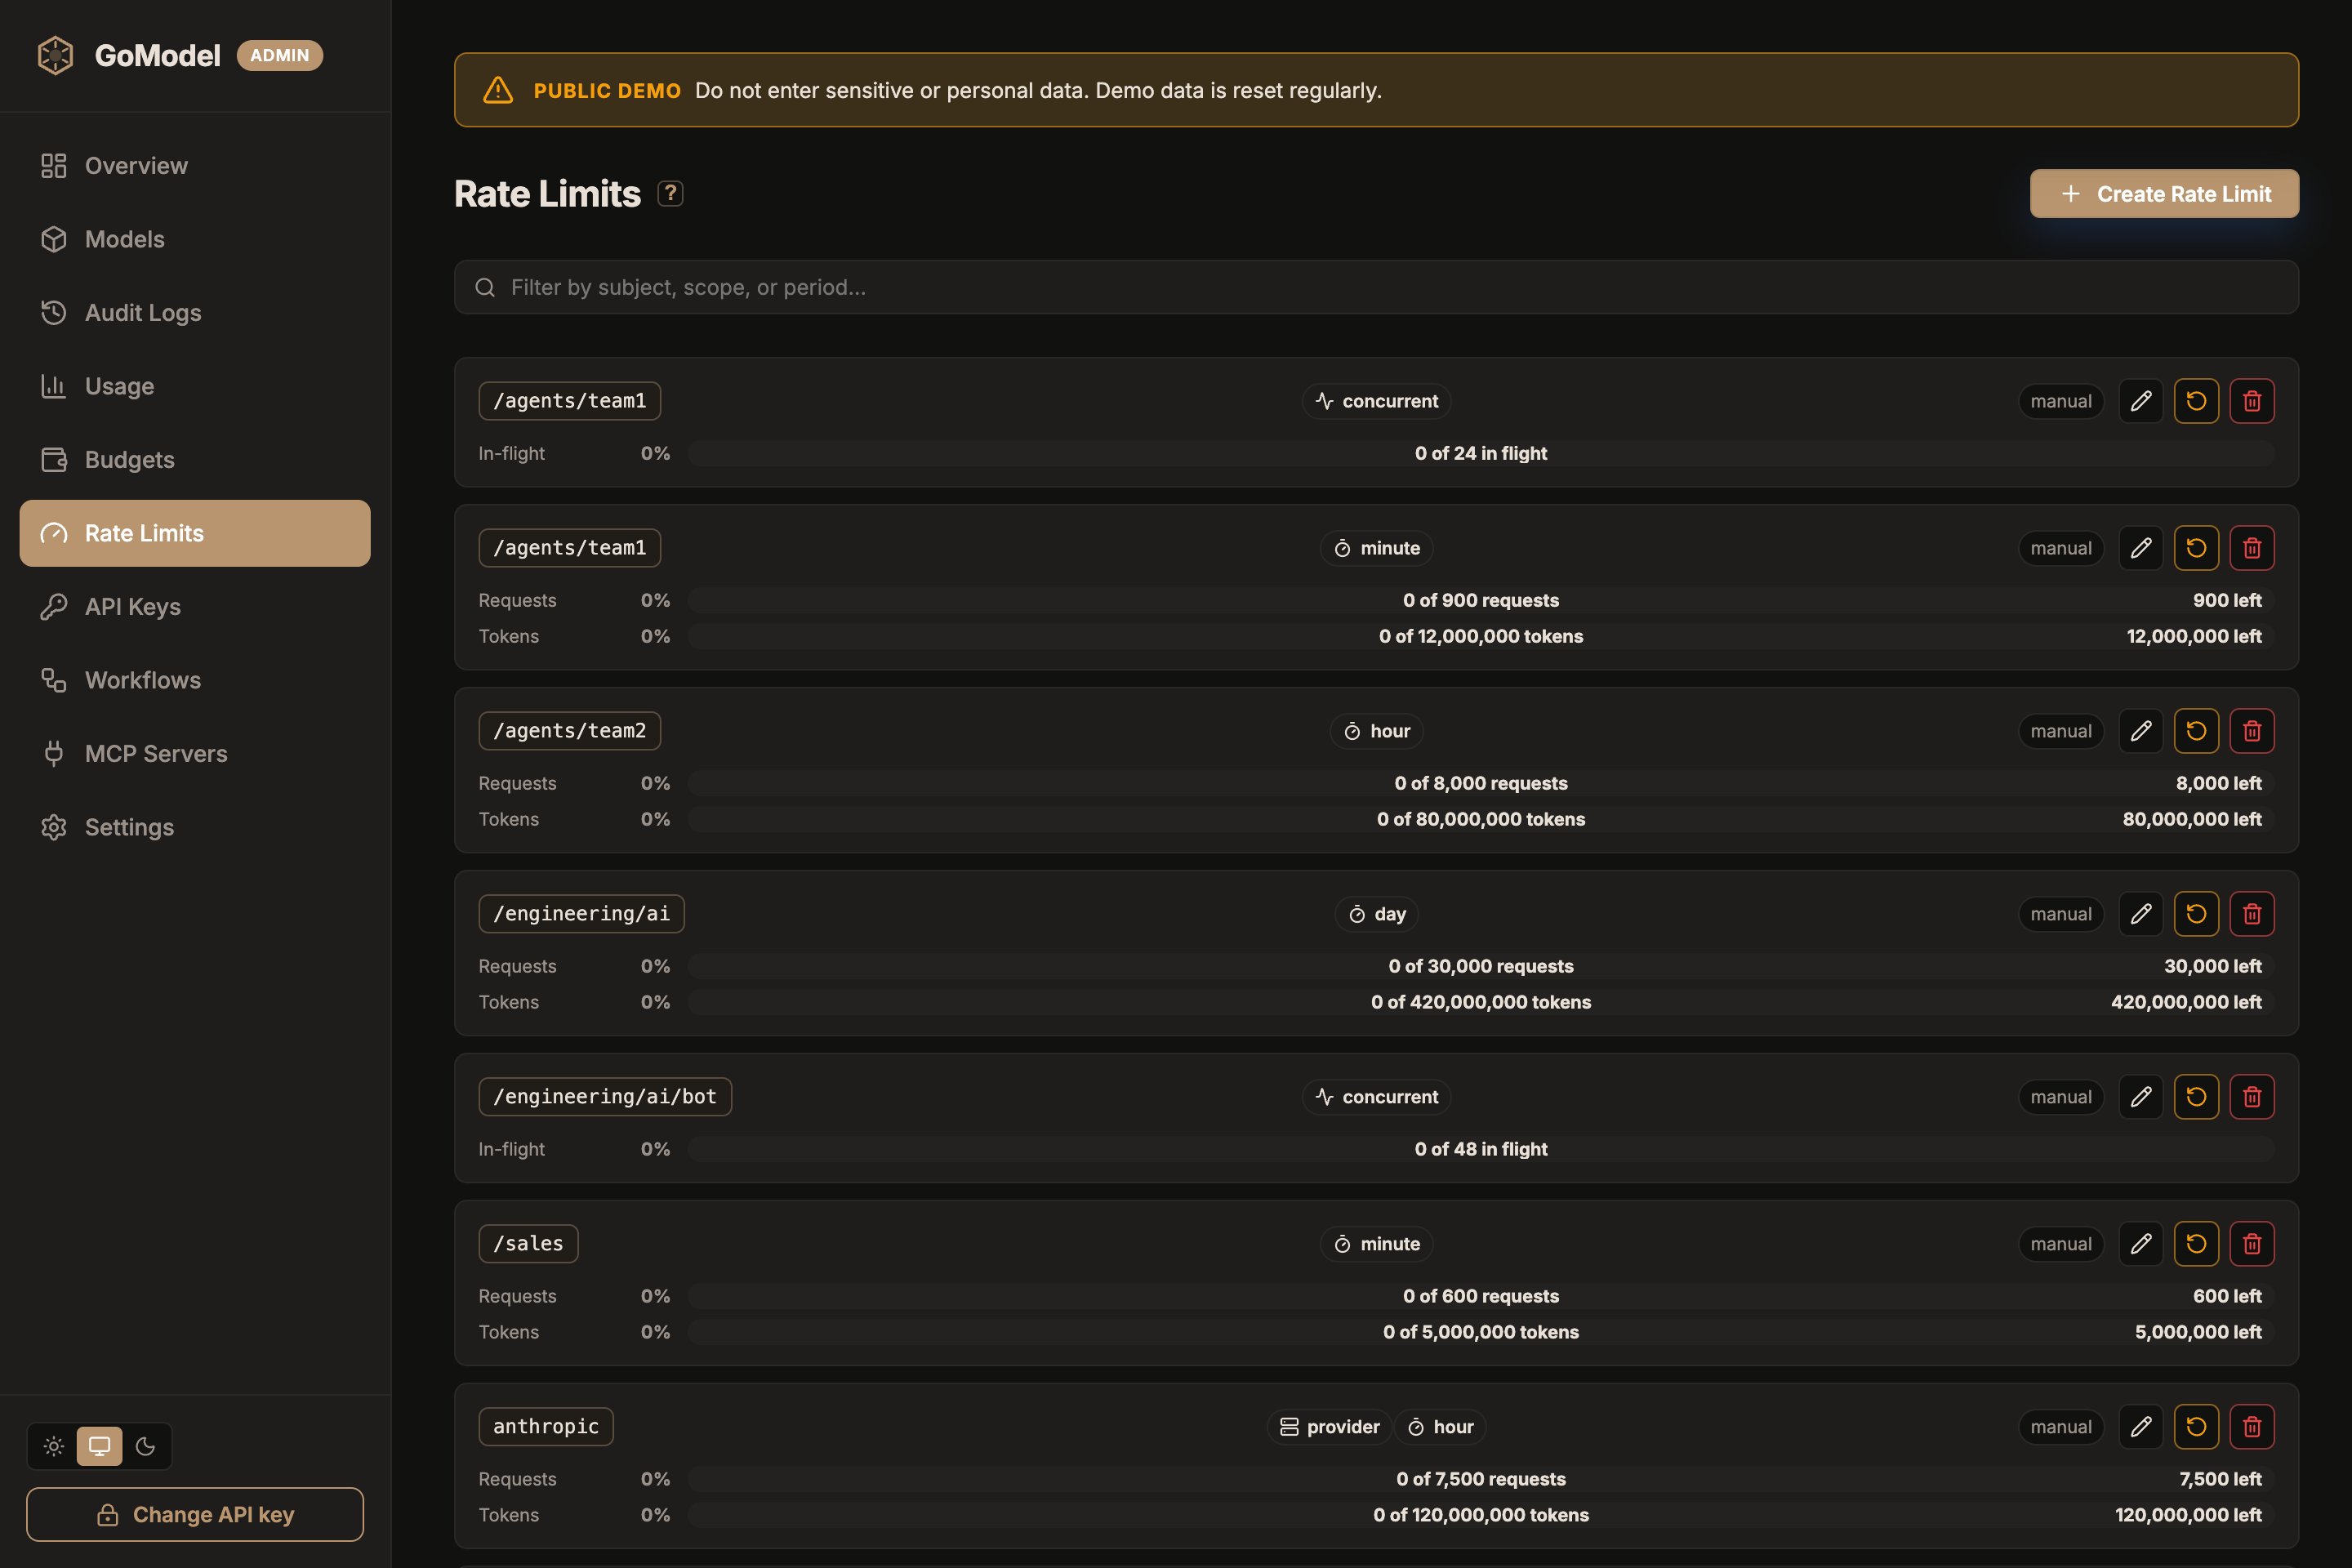
manual。从 YAML 或环境变量加载的规则标记为
config,并且在控制台中为只读。每一行都会显示相对于其限制的实时用量;重置图标仅清除该规则的计数器,垃圾桶图标会删除该规则(同时也会重置它)。
Models 页面在每个模型行和提供商标题上都有一个仪表按钮,可在上下文中打开该对象的相同限制:模型自身的规则、它所共享的提供商规则,
以及全局(根用户路径)规则——每条规则都带有实时用量——并提供添加和编辑操作。
编辑规则的作用域、限制对象或周期会移动该规则:规则会以新的键重新创建,其实时计数器会重新开始。仅编辑上限则会保留计数器。
从 YAML 预置规则:
SET_RATE_LIMIT_<PATH>(后缀映射到用户路径的方式与 SET_BUDGET_* 完全相同;
__ 用于分隔路径段);提供商规则使用 SET_PROVIDER_RATE_LIMIT_<NAME>(下划线会变为连字符,与提供商实例环境变量相同):
rpm/tpm 表示每分钟,rph/tph 表示每小时,rpd/tpd 表示每天,concurrent 表示进行中请求的上限。
如需自定义窗口,也可以使用由规则对象组成的 JSON 数组:
自定义窗口直接使用
period_seconds。
匹配与计数机制
规则路径适用于所配置的路径及其所有子路径,与预算完全相同:/team 上的规则匹配 /team/app,但不匹配 /team-alpha。
/ 上的规则适用于所有流量。
提供商规则按名称匹配解析后的提供商实例。模型规则匹配实际执行的模型:带提供商限定的对象(openai/gpt-4o)只覆盖某一个提供商的该模型,
裸对象(gpt-4o)则覆盖任意提供商上的该模型。匹配不区分大小写,规则会保留您书写时的拼写——提供商 openai-EU 上的规则会以
openai-EU 列出和报告,同时无论路由的大小写如何都能匹配。
每条规则为其整个限制对象维护一个共享计数器。 /team 上 100 rpm 的规则允许 /team 下所有内容合计每分钟 100 个请求;
提供商 openai 上 500 rpm 的规则由路由到该提供商的所有使用方和模型共享。如需按密钥限制,请将每个托管 API 密钥绑定到其独立的用户路径,
并在该路径上定义规则。
动态的按子路径速率限制在 GoModel Pro 中提供,并需要
quota_templates 许可证授权。没有该授权时,Admin API 写入会被拒绝,
返回 403 quota_templates_not_entitled;配置中的 per_child: true 会导致启动中止——GoModel 绝不会静默回退为单个共享的子树计数器,
因为这会改变限制的执行语义。per_child: true,即可将其转换为动态模板。此后每个直接子路径都拥有独立的计数器:当 /customers 上设置了模板时,
/customers/alice/app 与 /customers/alice 共享计数器,而 /customers/bob 则拥有另一个计数器。模板路径 /customers 本身不会被匹配。
提供商规则和模型规则不能设置为按子路径。
全局管理列表在显示 per child 模板时不会展示具有误导性的汇总计数器。GET /v1/usage 会根据调用方的用户路径解析模板,并返回对应子路径的实时计数器。
重置或删除模板会清除该定义下所有子路径的请求和 Token 窗口;正在占用的并发槽位会在其请求结束时正常释放。
所有匹配的规则都会被检查;第一个耗尽的限制会拒绝该请求。
提供商和模型限制会绕开饱和目标
饱和的提供商或模型的表现与库存信息过时的提供商或模型相同:- 虚拟模型负载均衡会跳过饱和的目标并选择下一个可用目标,因此带有多个目标的别名可以继续提供服务。当所有目标都饱和时,
别名仍会解析到其第一个目标,从而让客户端收到如实的
429和Retry-After(或由故障转移接管),而不是模型不可用错误; 在此期间,该别名始终保留在/v1/models列表中。 - 故障转移链会接管饱和的主路由:主提供商永远不会被调用(否则它会照常处理请求,从而让限制失效),对重定向剩余目标的遍历会立即开始, 遍历过程中也会跳过速率已饱和的候选目标。
- 没有虚拟模型的直接请求会收到
429和如实的Retry-After——与提供商自身最终给出的答复相同,只是省去了一次浪费的上游调用。 使用方(用户路径)超出限制时始终返回429:切换目标无法缓解这种情况。
- 请求窗口使用滑动窗口估算,因此突发流量不会在窗口边界处翻倍。
- Token 用量在每个响应完成后计数(包括流式响应)。在计数器更新之前,单个请求可能会超出 Token 窗口——这与其他根据响应统计 Token 的网关行为相同。
- 响应缓存命中会在限制执行之前返回,不计入任何计数。
- 一个 Realtime 会话计为一个请求,并在整个会话期间占用一个并发槽位。一次批处理提交计为一个请求,不占用并发槽位。
- 请求和 Token 窗口保存在内存中用于准入判断,并大约每秒一次(以及关闭时)快照到所配置的存储中,因此在重启和
gomodel --reload后依然保留。并发计量不会持久化:重启后没有进行中的请求。在 N 个副本的情况下,实际限制仍约为配置值的 N 倍——如需持久化的跨实例控制,请使用预算。 可通过RATE_LIMITS_FLUSH_INTERVAL调整快照间隔(单位为秒;默认1;0会跳过周期性写入,但仍会在启动时加载并在正常关闭时写出)。
客户端行为
超出限制的请求会收到:429,并带有 Retry-After 响应头,其值为在滑动窗口下重试真正能被接受之前需要等待的秒数(可能超过下一个窗口边界)。
OpenAI SDK 遇到这种格式时会自动退避。
超出限制的响应还会携带所触发限制对应的 x-ratelimit-* 响应头:对于请求或 Token 窗口,包括 limit/remaining/reset。
并发超限会发送 x-ratelimit-limit-requests 和 x-ratelimit-remaining-requests(始终为 0),但不会发送
x-ratelimit-reset-requests:进行中计量没有可重置的窗口——请求结束时槽位即被释放,这正是 Retry-After 所估算的时间。
受限路径上的成功响应会携带来自限制最严格的匹配规则的 OpenAI 风格响应头:
Admin API
user_path 是 "scope": "user_path", "subject": ... 的简写):
POST /admin/rate-limits/reset-one,请求体为
{"scope": ..., "subject": ..., "period": ...}),也可以重置所有规则的计数器
(POST /admin/rate-limits/reset,请求体为 {"confirmation": "reset"})。编辑规则永远不会重置其计数器;删除规则则会。
端点列表请参阅管理端点。