

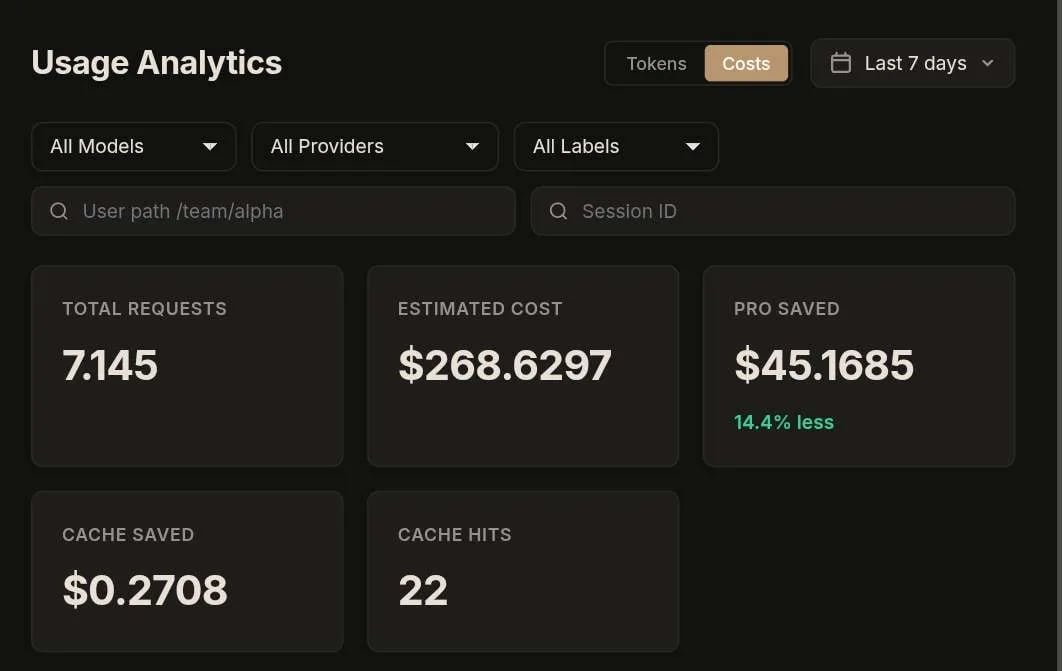
控制台 Usage 页面:七天生产流量中 Pro 节省的费用。
经过生产环境验证
提示词压缩已在智能体编程、聊天和大量使用工具的工作负载中,经过数十亿生产 Token 的检验。- 无损。 压缩只会将模型在同一请求中已经看过的内容替换为对它的引用,或以可逆方式重新编码结构化数据。模型接收到的信息完全相同;不会对任何内容进行摘要或丢弃。唯一有损的选项——工具结果裁剪——是一个单独的策略,默认关闭。
- 不降低提示词缓存效果。 由于会话中先前发送过的前缀会逐字节重放,只有新消息会被改写,因此提供商的提示词缓存在多轮对话中仍能持续命中。测试者实际观察到提示词缓存命中率提升了约 2%,因为更短、更稳定的请求更适合缓存——这在压缩本身之外又带来了额外的节省。
- 为测试者实际节省 2%–20% 的输入 Token,具体取决于使用场景。会重复读取文件、重放工具输出或携带长历史记录的智能体处于该区间的上端;简短、不重复的聊天处于下端,此时压缩器只是原样转发请求。
- 完全可控。 可按网关或按请求选择级别,通过 glob 排除模型,使用
new_messages_only保护已有历史记录,保持源代码原样,并通过响应头、审计修订记录和指标检查每一次改写。
概览
提示词压缩会在受支持的推理请求到达提供商之前对其进行改写。它会减少重复或结构性的上下文,同时保留请求中的非文本结构。 它支持POST /v1/chat/completions、POST /v1/messages 和
POST /v1/responses。工具调用参数、非文本部分和未知 JSON
字段都保持不变。Responses 推理项始终原样重放,因为 Responses API 可能要求它们与函数调用一同出现。
默认的 high 策略将连续行去重与规范化结合使用:
- 文件读取结果中的行号栏会变为紧凑的范围标头
- 在安全的情况下,移除重放的 Chat Completions 推理内容
- 已知的工具结果封装、搜索结果、日志、JSON 和统一 diff 使用内容感知的规范化
- 能带来收益的同构 JSON 数组和结构化日志使用可逆的、自描述的编码
new_messages_only。
配置压缩
设置
PRO_COMPRESSION_LEVEL=none 可为整个网关禁用压缩。如果只针对单个请求,请发送:
none 级别都会跳过请求体解析,因此请求会被原样转发。
检查压缩效果
经过压缩的响应包含估算的节省量以及被替换的重复块数量:LOGGING_LOG_BODIES=true 时,还会保留改写后的请求体。Prometheus 指标使用
gomodel_pro_compression_ 前缀,控制台的 Usage 页面会以 Token 或成本的形式报告 Pro 节省量。