

Przegląd
Guardrail to nazwana, skonfigurowana instancja pluginu. Guardrails działają w każdym workflow, który się do nich odwołuje, w jednej z trzech faz:- prompt: po routingu, zanim request dotrze do providera
- response: na kompletnej odpowiedzi, zanim dotrze do klienta
- stream: na każdym streamowanym zdarzeniu (lub na zbuforowanym streamie, zależnie od pluginu)
/v1/responses guardrail fazy stream może pomijać, scalać lub dzielić
zdarzenia, więc GoModel numeruje na nowo to, co dostarcza: sequence_number
nadal biegnie od 0 bez przerw, aż do końcowego response.completed (albo
response.incomplete / response.failed przy przerwanym streamie).
Guardrails działają we wszystkich endpointach tekstowych:
/v1/chat/completions/v1/responses/v1/messages/v1/decisionsi/v1/systemone, tylko faza prompt (zobacz Działanie z różnymi endpointami)
Guardrails dla modeli obrazów, TTS, STT i wideo są planowane jako osobny
system i nie są tu opisane.
Szybki start
Dodaj sekcjęguardrails do swojego config/config.yaml:
Zarządzanie z dashboardu
Definicje guardrails można też tworzyć i edytować z dashboardu administracyjnego zamiast wconfig.yaml – przydaje się to przy iterowaniu
nad regułami bez ponownego wdrożenia albo dla operatorów, którzy nie zarządzają
bezpośrednio konfiguracją w tym repozytorium.
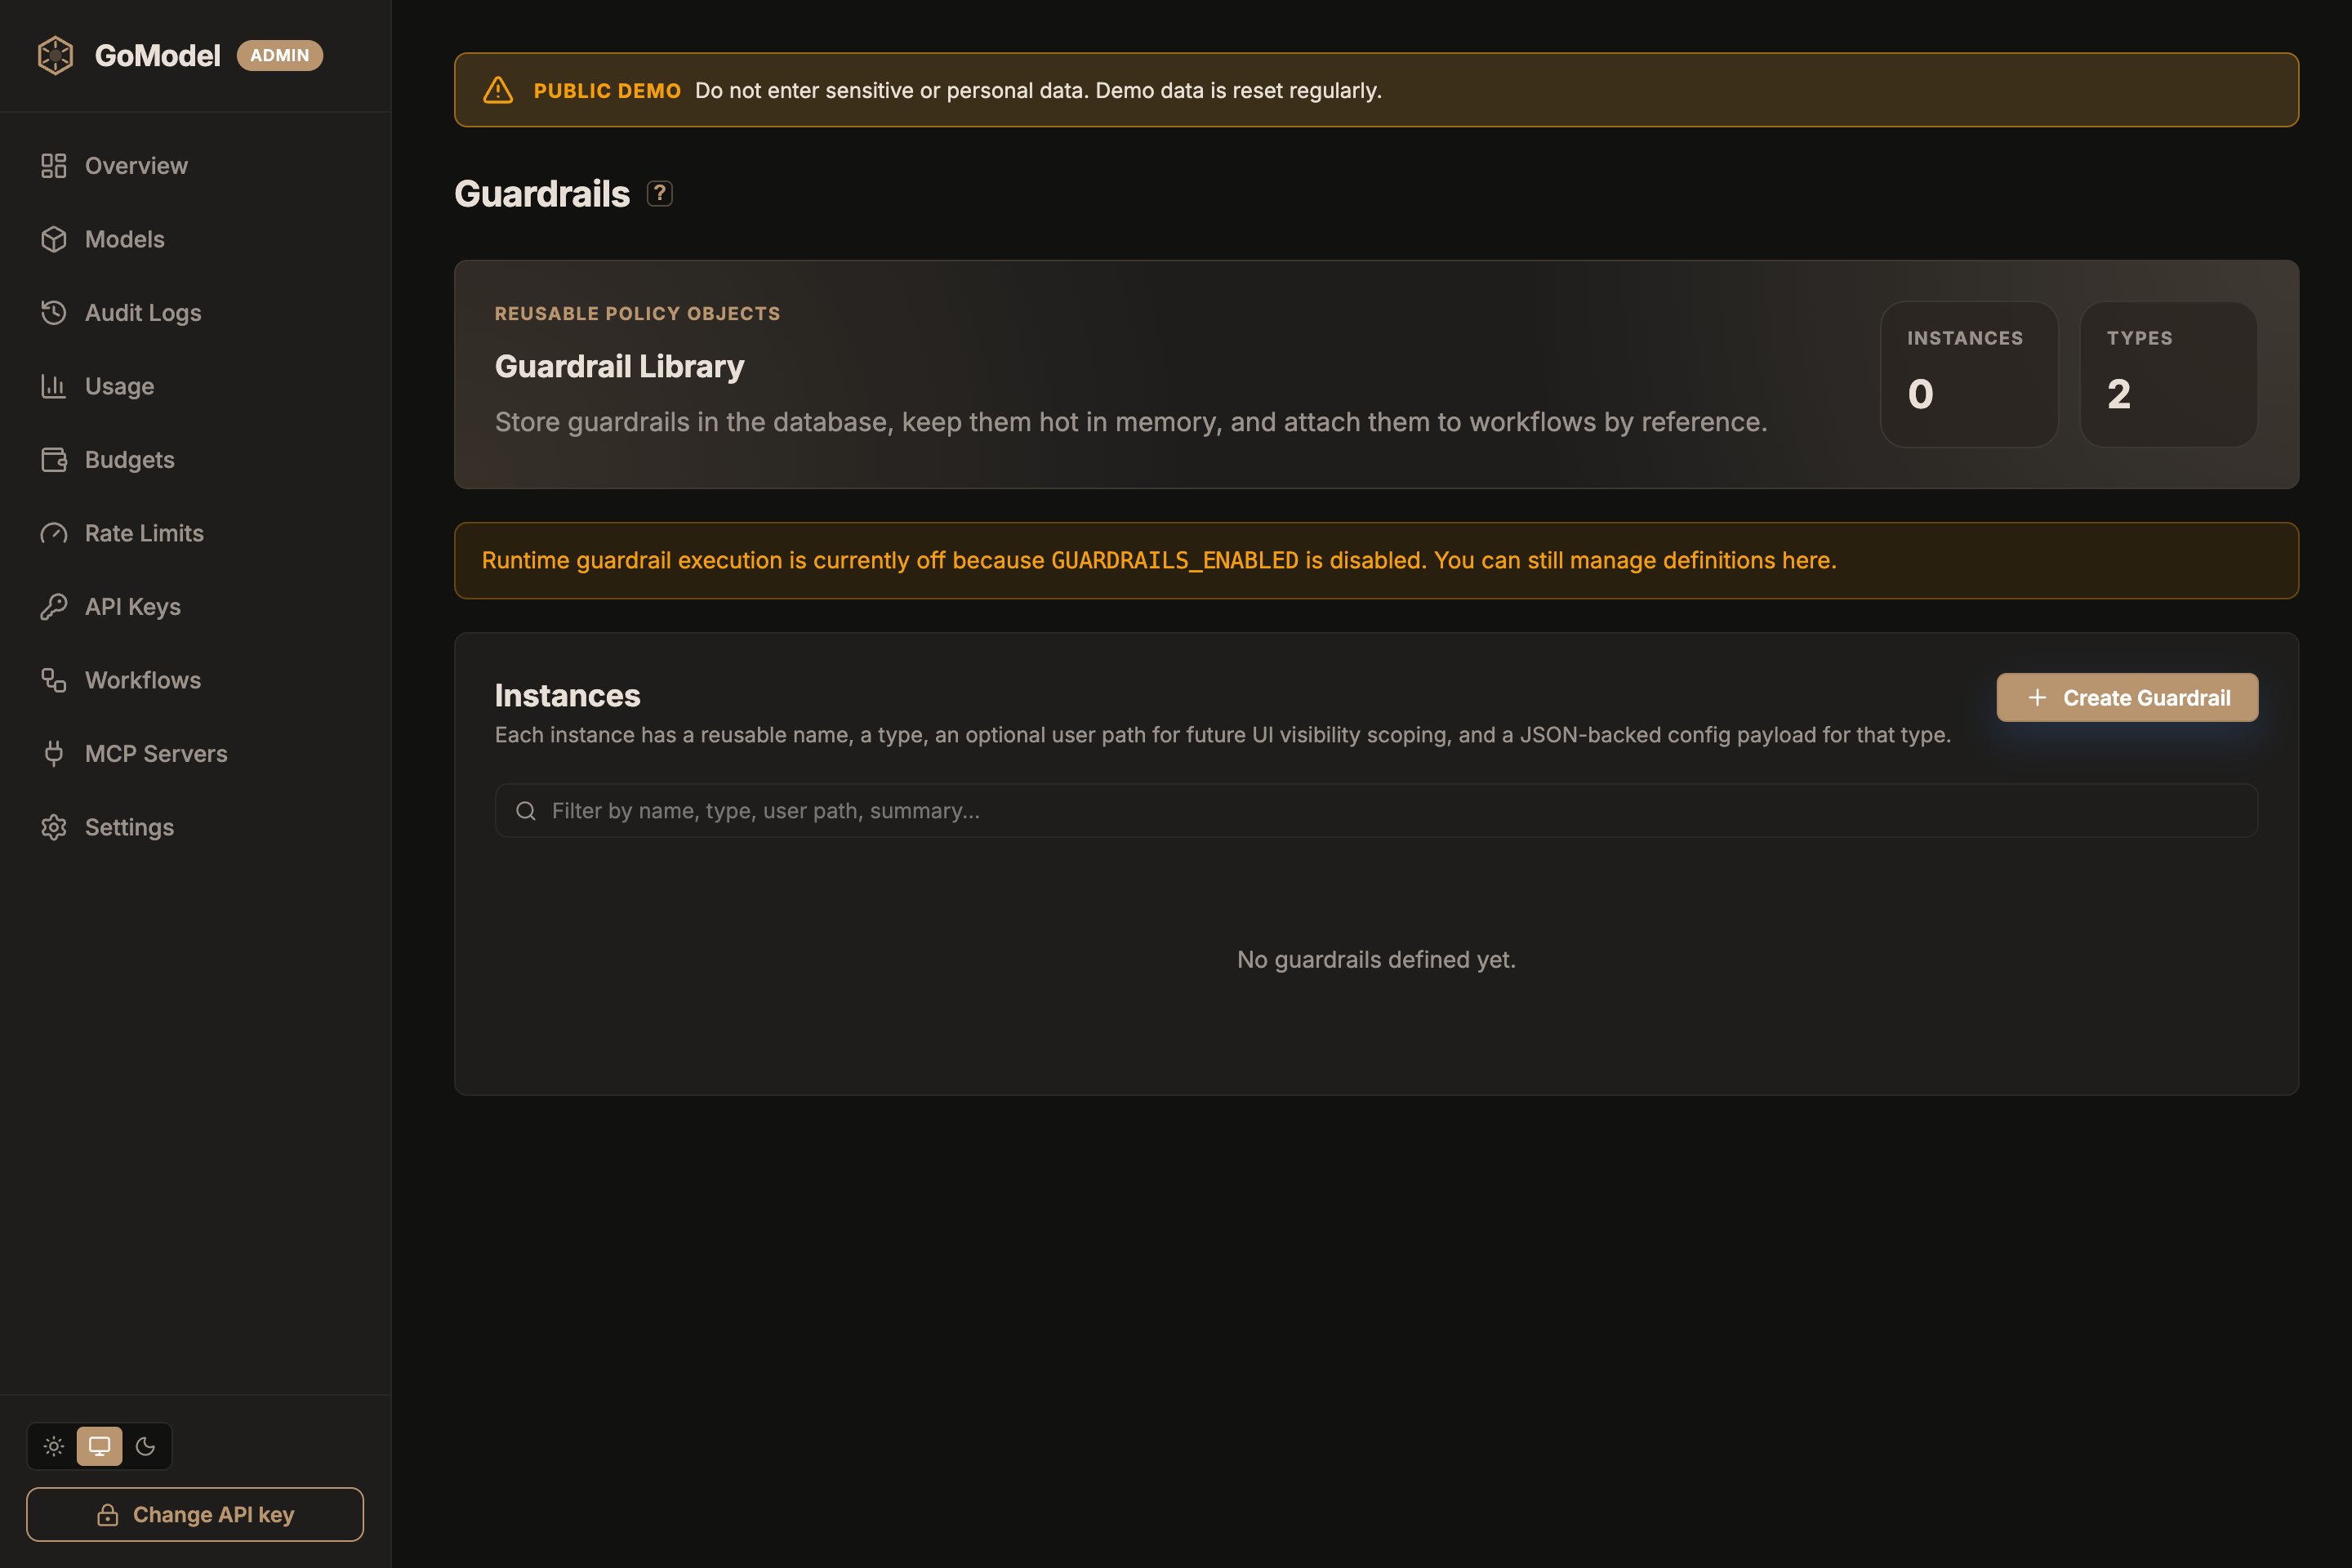
user_path i wypełnij
formularz zadeklarowany przez plugin. Sekcja Advanced zawiera tryb
obsługi błędów i timeout. Wpisy z config.yaml są przy starcie zapisywane w
tym samym magazynie i pozostają z nim zsynchronizowane, więc guardrails
utworzone w dashboardzie i zadeklarowane w konfiguracji widać obok siebie.
Lista Plugins na dole strony pokazuje każdy załadowany typ pluginu, jego
hooki, źródło i stan. Nie każdy plugin jest guardrailem:
plugin deklaruje Guardrail: true w swoim manifeście, gdy jego instancje
stosują politykę do promptów, odpowiedzi lub streamów, a dashboard oznacza
takie pluginy i zbudowane z nich instancje tarczą. Strategia routingu, taka jak
cheapest_healthy, jest wymieniona na tej samej stronie, ale nie jest
guardrailem.
Wykonywanie guardrails w czasie działania nadal zależy od
GUARDRAILS_ENABLED. Gdy jest wyłączone, strona nadal pozwala zarządzać
definicjami – po prostu nie działają jeszcze na ruchu produkcyjnym.Jak to działa
- Request jest mapowany na ujednolicony
Prompt(wiadomości system, user, assistant i tool ze stabilnymi ID) - Uruchamiany jest łańcuch prompt: każdy guardrail edytuje prompt albo decyduje o zablokowaniu, odpowiedzi lub ostrzeżeniu
- Edycje są nanoszone z powrotem na oryginalny request, który trafia dalej do providera
- Łańcuch response działa na kompletnej odpowiedzi (albo łańcuch stream na streamie), zanim cokolwiek dotrze do klienta
Exchange. Ten sam
guardrail działa identycznie dla /chat/completions, /responses i
/messages.
Kolejność wykonywania
Każdy guardrail ma wartośćorder (krok workflow), która określa, kiedy
działa w obrębie swojej fazy:
- Ta sama wartość order → działają równolegle (współbieżnie)
- Różne wartości order → działają sekwencyjnie (rosnąco)
system_prompt, llm_based_altering,
string_replace, presidio), nie mogą współdzielić wartości order z innym
guardrailem edytującym; tylko jeden edytor na order i dowolna liczba
nieedytujących sprawdzeń (llm_judge, header_edit) obok niego. Gdy kilka
guardrails o tym samym order podejmuje różne decyzje, wygrywa najostrzejsza:
block > respond > warn > allow.
Konfiguracja
Pełna struktura
system_prompt i llm_based_altering przyjmują też swoje ustawienia w
typowanym bloku nazwanym tak jak typ (system_prompt: / llm_based_altering:),
jak w Szybkim starcie. Typowany blok i config: są równoważne; dla wszystkich
pozostałych typów używaj config:. Klucze liniowe, takie jak
string_replace.rules i listy header_edit, przyjmują albo blokowy skalar
(|), albo listę YAML stringów łączonych znakami nowej linii.
Zmienna środowiskowa
Możesz włączać i wyłączać guardrails bez edytowania pliku konfiguracyjnego:PLUGINS_ENABLED, domyślnie wyłączony). Gdy oba
są wyłączone, endpointy guardrails i strona w dashboardzie są niedostępne.
Pola reguły
Typy guardrails
GoModel dostarcza sześć typów. Każdy jest wbudowanym pluginem; tabele wymieniają jego klucze konfiguracji tak, jak występują podconfig: i w
formularzu dashboardu.
system_prompt
Dodaje, zastępuje lub dekoruje system prompt w każdym requeście.
Fazy: prompt. Edytuje treść: tak.
Ustawienia
Tryby
- inject
- override
- decorator
Dodaje wiadomość systemową tylko wtedy, gdy żadnej nie ma. Istniejące system prompty pozostają nietknięte.Zachowanie:
- Request nie ma system promptu → dodaje go
- Request ma już system prompt → bez zmian
llm_based_altering
Przepisuje tekst wiadomości o wybranych rolach, wywołując model pomocniczy.
W fazie prompt przepisuje request; w fazie response przepisuje odpowiedź
asystenta (gdy roles zawiera assistant). Przydaje się to do anonimizacji
danych osobowych (PII) i innych przepisań zachowujących treść.
Domyślny prompt wywodzi się z guardraila data_anonymization z LiteLLM,
więc minimalna konfiguracja działa jak preprocesor anonimizujący.
Fazy: prompt, response. Edytuje treść: tak.
Ustawienia
Przepisania przechodzą wewnątrz procesu przez zwykłą ścieżkę tłumaczonych
requestów, więc wybór workflow, failover, użycie, audyt i cache nadal działają.
Wewnętrzny request używa:
- ścieżki:
/v1/chat/completions - ścieżki użytkownika:
{guardrail.user_path or caller user path}/guardrails/{guardrail name} - pochodzenia requestu:
plugin
fail_mode: closed
odrzuca request, open kontynuuje z oryginalnym tekstem.
Przykład
string_replace
Zastępuje, oznacza lub blokuje tekst pasujący do listy reguł dosłownych lub
wyrażeń regularnych. Działa na promptach, odpowiedziach i streamach. W każdym
trybie reguły dopasowują się w obrębie jednej części tekstu (części treści lub
części z wynikiem narzędzia); tekst rozdzielony między dwie części nie jest
dopasowywany.
Fazy: prompt, response, stream. Edytuje treść: tak.
Ustawienia
W fazie stream
replace i warn przekształcają zdarzenia w locie ze
skonfigurowanym lookbehindem. block i respond buforują cały stream, aby nic
nie wyciekło przed podjęciem decyzji – kosztem opóźnienia pierwszego tokena do
momentu, gdy odpowiedź będzie kompletna.
Przykład
tag_replace
Zastępuje placeholdery {{gomodel.<tag>}} w tekście promptu wartościami
bieżącego requestu, tuż przed wywołaniem providera. Użyj go, aby przekazać
modelowi, jako jaki model działa, albo dzisiejszą datę, bez wysyłania tych
danych przez klienta. Dobrze łączy się z system_prompt: umieść tagi w system
prompcie i uruchom tag_replace z późniejszym order.
Fazy: prompt. Edytuje treść: tak.
Tagi
Spacje wewnątrz nawiasów klamrowych są dozwolone. Nieznane tagi pozostają bez
zmian.
Tag bez wartości dla danego requestu, np.
session_id bez sesji, staje się
pusty. Tagi modelu i providera wskazują pierwszego wybranego providera: faza
prompt działa raz, więc próba failoveru otrzymuje ten sam tekst. Wartości
pochodzące od wywołującego, takie jak user_path i session_id, są wstawiane
w wysłanej postaci. Request, w którego prompcie rozwinięto tag, nie jest
zapisywany w cache’u odpowiedzi, ponieważ odpowiedź może powtarzać wartości
specyficzne dla requestu.
Ustawienia
Przykład
header_edit
Ustawia, dodaje i usuwa nagłówki HTTP w requeście, w odpowiedzi do klienta i
w wywołaniu providera upstream. Nigdy nie edytuje treści, więc może
współdzielić order z guardrailem edytującym.
Fazy: prompt, response. Edytuje treść: nie.
Ustawienia
Każdy klucz to lista linii. Linie set i add mają postaćName: value; linie
remove to sama Name. Puste linie i komentarze # są ignorowane.
Nagłówków z danymi uwierzytelniającymi (
Authorization, X-Api-Key,
Cookie, …) nigdy nie można edytować, a nazw zawierających secret lub
token nie można ustawiać.
Przykład
llm_judge
Pyta model sędziego, czy prompt (lub odpowiedź) narusza politykę, i na
podstawie werdyktu blokuje, odpowiada lub oznacza request. Sędzią jest model
czatowy albo model decyzyjny:
- Model czatowy musi odpowiedzieć jednym obiektem JSON
{"verdict":"allow"|"block","reason":"..."}. Domyślne instrukcje o to proszą i każą modelowi ignorować instrukcje zawarte w treści. - Model decyzyjny (Jev, Kev, modele decyzyjne OpenRouter albo model OpenAI przez Decisions API) dostaje pytanie tak/nie i zwraca prawdopodobieństwo odpowiedzi „tak”. Nie ma tekstu do parsowania, a rozliczane są tylko tokeny wejściowe. Zobacz Ocena modelem decyzyjnym.
Ustawienia
Identyczny tekst jest oceniany raz na request, więc instancja działająca
zarówno w fazie prompt, jak i response nie nalicza podwójnie opłat za tę samą
treść. W fazie stream cały stream jest buforowany i oceniany jako kompletna
odpowiedź.
Ocena modelem decyzyjnym
Z modelem decyzyjnym sędzia wysyła oceniany tekst jako wejście Decisions, bez tagów, i zadaje jedno pytanie typu predicate:decision_question. Nie używa
prompt, max_tokens ani temperature. Prawdopodobieństwo równe
block_threshold lub wyższe to werdykt block i stosowane jest action. Niższe
prawdopodobieństwo przepuszcza treść. Wywołanie przechodzi przez ten sam routing
co POST /v1/decisions: modele wirtualne, failover
na cele obsługujące Decisions, dokładny cache odpowiedzi, użycie i audyt, w ramach
ścieżki użytkownika instancji.
Każdy werdykt zapisuje prawdopodobieństwo w szczegółach decyzji (probability),
a instancja raportuje je jako histogram
plugin_llm_judge_decision_probability. Użyj ich, żeby dostroić
block_threshold dla każdej polityki: podnieś go, żeby blokować tylko wyraźne
naruszenia, albo obniż, żeby wyłapywać więcej treści granicznych.
engine: auto rozpoznaje modele odpowiadające tylko na decyzje na podstawie
katalogu modeli. Model OpenAI z obsługą Decisions obsługuje też czat, więc
auto odpytuje go przez czat. Ustaw engine: decision, żeby zamiast tego użyć
jego Decisions API.
Nie włączaj judge_images dla sędziego, który czyta tylko tekst, takiego jak
serwer Kev: z obrazami każde wywołanie kończy się błędem i decyduje fail_mode.
Hostowany Jev czyta obrazy wysłane jako data URL-e base64. Przy włączonym
judge_images oceniany jest też prompt zawierający wyłącznie obraz; w
przeciwnym razie jest przepuszczany bez wywołania sędziego.
Dobór max_tokens dla sędziego z reasoningiem
Model sędziego z reasoningiem zużywa completion na myślenie, zanim cokolwiek
napisze: przy limicie, który wyczerpie się wcześniej, sędzia nie zwraca
werdyktu, a instancja niczego nie egzekwuje – zamiast tego stosuje
on_unclear, które domyślnie tylko ostrzega. Domyślny limit 2048 zostawia na
to miejsce; za niewykorzystane tokeny nigdy nie płacisz, więc gdy model sędziego
dużo rozumuje, raczej podnieś limit, niż go obcinaj.
Sędzia, który nie dochodzi do werdyktu, jest zapisywany osobno od odpowiedzi,
która nadeszła, ale nie dała się sparsować:
Po skonfigurowaniu instancji sprawdź w logu gatewaya komunikat
judge returned no verdict i ustaw on_unclear: block dla polityki, która
musi obowiązywać nawet wtedy, gdy sędzia nie odpowie niczym użytecznym.
Wywołanie sędziego, które zakończy się wprost błędem – błąd providera,
timeout – nie jest niejasnym werdyktem: decyduje o nim fail_mode, jak przy
każdym innym błędzie guardraila.
Przykład
presidio
Wykrywa dane osobowe za pomocą analizatora
Presidio i anonimizuje je, oznacza
lub blokuje. Potrzebna jest tylko usługa analizatora; GoModel sam przepisuje
tekst, więc może wstawić oryginalne wartości z powrotem do odpowiedzi.
Ustawienia
Każda część tekstu jest analizowana osobno (jedno wywołanie analizatora na
część, do ośmiu jednocześnie), więc analizator nigdy nie widzi całej rozmowy
jako jednego tekstu, a jego własne limity dotyczą każdej części. Szczegóły
audytu zapisują typy encji i ich liczby, nigdy wartości, a błędy analizatora
nigdy nie zawierają przekazanego mu tekstu. Analizator otrzymuje tekst jawnie,
więc uruchamiaj go jako sidecar na tym samym hoście albo łącz się z nim przez
https:// lub sieć prywatną.
W fazie stream anonymize i warn przekształcają zdarzenia w locie w
chunkach po stream_chunk znaków z nakładaniem stream_lookbehind; typ z
block_entities znaleziony w trakcie streamu przerywa stream, zanim ten chunk
dotrze do klienta. block i respond buforują cały stream, aby nic nie
wyciekło przed podjęciem decyzji.
Przywracanie wartości
Przyrestore: true faza prompt zastępuje wartości numerowanymi
placeholderami i zapamiętuje je na czas requestu; faza response lub stream
wstawia wartości z powrotem tam, gdzie model powtarza placeholder – w tekście,
reasoningu (reasoning_content lub reasoning) i argumentach wywołań
narzędzi – więc klient widzi własne dane, a provider nigdy ich nie widzi.
Ustaw restore na instancjach w obu fazach: instancja fazy prompt zapisuje
wartości, a instancja fazy response je przywraca. Reasoning jest tylko
przywracany, nie analizowany. Przywrócony reasoning, który klient czatu
odsyła w następnej turze (reasoning_content, którego DeepSeek wymaga przy
wywołaniach narzędzi), jest w fazie prompt ponownie anonimizowany, tak jak
reszta historii. Podpisane bloki thinking Anthropic są przesyłane osobno i
nigdy nie są edytowane; w /v1/messages, gdzie klient odsyła tekst thinking
razem z podpisem, thinking Anthropic zachowuje placeholdery. Elementy
reasoningu w wyniku /v1/responses (podsumowania i tekst reasoningu) również
zachowują placeholdery: klienty odtwarzają je w input w niezmienionej
postaci, więc przywrócone wartości trafiłyby do providera w następnej turze.
Instancja fazy prompt potrzebuje restore, aby zapisać wartości; instancja
przywracająca odczytuje restore_tools i restore_tools_exclude.
restore_roles odczytują obie: wartości danej roli wracają, gdy każda
instancja ustawiająca restore_roles wymienia tę rolę albo – gdy żadna go nie
ustawia – gdy wymienia ją lista domyślna.
Przywracane są tylko wartości z restore_roles (domyślnie wiadomości
użytkownika, wcześniejsze tury asystenta i wyniki narzędzi); wartość z
wiadomości system lub developer pozostaje placeholderem, więc użytkownik nie
może skłonić modelu do jej ujawnienia. Dodaj system, gdy wiadomość
systemowa zawiera własne dane użytkownika (nazwę użytkownika lub wspomnienia z
frontendu czatu), a każdy, kto może korzystać z wdrożenia, może je zobaczyć.
Wartość, którą model wygenerował samodzielnie, jest
nadal anonimizowana na wyjściu. Takie odpowiedzi nie trafiają do
cache’u odpowiedzi. Tekst w kształcie placeholdera,
który już jest w rozmowie, np. <PERSON_2> przyniesiony przez wcześniejszą
odpowiedź, pozostaje bez zmian, a jego numer nigdy nie jest ponownie używany
dla nowej wartości.
Placeholdery są wykrywane bez względu na wielkość liter (<Person_1>) oraz
po zescape’owaniu w Markdownie lub HTML-u (\<PERSON\_1\>, <PERSON_1>).
Streamowany tekst, reasoning i argumenty każdego wywołania narzędzia są
przywracane w locie, każde we własnym oknie w ramach stream_lookbehind, w
tym placeholdery, których nawiasy ostre provider zescape’ował (Gemini zwraca
\u003cPERSON_1\u003e).
Domyślnie argumenty wywołań narzędzi są przywracane dla każdego narzędzia.
Narzędzie uruchamiane po stronie klienta, które wysyła swoje argumenty do
podmiotu trzeciego, takie jak wyszukiwanie w sieci, powinno zachować
placeholdery: wymień je w restore_tools_exclude albo wymień w
restore_tools tylko narzędzia, które potrzebują wartości (wyszukiwanie w
bazie wiedzy, pytanie użytkownika, generowanie dokumentów).
Renderer Markdowna, który sanityzuje HTML, może ukryć placeholder pozostawiony
w odpowiedzi (wymyślony przez model albo pochodzący z system promptu). Ustaw
placeholder_format: "[{entity}_{n}]", aby pozostały widoczne. Instancje
działające na jednym requeście współdzielą placeholdery w formacie pierwszej
uruchomionej instancji, więc nadaj im ten sam format.
Przykład
Przykłady
Pojedynczy guardrail bezpieczeństwa
Najprostsza konfiguracja – dodaj prefiks bezpieczeństwa do każdego requestu:Sprawdzenia równolegle z edytorem
Nieedytujące sprawdzenie współdzieli order0 z edytorem system promptu i
działa współbieżnie z nim:
Pipeline sekwencyjny
Guardrails o różnych wartościach order działają jeden po drugim. Późniejsze grupy widzą wynik wcześniejszych:Faza response: usuwanie sekretów na wyjściu
Działa na kompletnej odpowiedzi, zanim dotrze ona do klienta. Ustawfail_mode: open, jeśli wolisz nieocenzurowaną odpowiedź od błędu 500, gdy
zawiedzie sam guardrail.
Faza stream: usuwanie w locie i ocena całej odpowiedzi
Do tej samej instancji można się odwołać w kilku fazach.mask-keys
przekształca streamowane chunki w locie (64 znaki lookbehindu, więc klucz
rozdzielony między dwa chunki nadal zostanie wyłapany). answer-judge
potrzebuje całej odpowiedzi, więc buforuje stream, a klient otrzymuje go po
wydaniu werdyktu.
Działanie z różnymi endpointami
Guardrails wewnętrznie operują na ujednoliconym formacie wiadomości. Dostosowanie między typami requestów specyficznymi dla API a tym formatem odbywa się automatycznie:/v1/decisions i /v1/systemone uruchamiają tylko fazę prompt: ich
odpowiedzi to typowane wartości, a nie completions, więc guardrails faz
response i stream są tam pomijane, z jednym ostrzeżeniem na guardrail. Edycje,
których nie mogą przenieść, np. wstrzyknięty system prompt, są pomijane.
W /v1/messages request, który uruchamia jakikolwiek guardrail, idzie ścieżką
tłumaczoną (natywny passthrough jest pomijany). Odpowiedź ucięta przez
guardrail jest raportowana z finish_reason: "content_filter" w endpointach
kompatybilnych z OpenAI i stop_reason: "end_turn" w /v1/messages.
Guardrails a cache odpowiedzi
Cache odpowiedzi przechowuje odpowiedź już wygenerowaną przez łańcuchy response i stream, a cache hit odtwarza ją bez ponownego uruchamiania tych łańcuchów. Obie warstwy cache’u używają więc w kluczu łańcucha guardrails, do którego rozwiązuje się request, we wszystkich trzech fazach:- Edycja, dodanie lub usunięcie kroku sprawia, że każdy wpis zapisany pod starym łańcuchem staje się nieosiągalny; następny request przechodzi cały pipeline i zapisuje własny wpis.
- Dwa workflow z różnymi łańcuchami nigdy nie współdzielą wpisów, więc tenant, którego workflow ocenzurowuje odpowiedzi na wyjściu, nigdy nie dostanie nieocenzurowanej odpowiedzi innego tenanta.
- Zablokowana odpowiedź nie nadaje się do cache’owania, więc cache hit nigdy nie pozwoli pominąć blokującego guardraila.
restore w
presidio).
Ponieważ przy cache hicie łańcuch response nie działa, wpis audytowy dla
trafienia zapisuje tylko wyniki fazy prompt oraz typ cache’u.
Decyzje, błędy i odrzucenie
Zablokowany request nigdy nie dociera do providera; zablokowana odpowiedź
nigdy nie dociera do klienta. Zobacz Pluginy,
aby dowiedzieć się, jak łączą się decyzje, gdy kilka guardrails działa z tym
samym order.
Każdy wynik, łącznie z cichym przepuszczeniem, jest zapisywany we wpisie
audytowym requestu w
data.guardrails – z fazą, krokiem, decyzją,
informacją, czy guardrail edytował request lub odpowiedź, i sposobem, w jaki
zawiódł. Na tej podstawie dashboard koloruje kroki guardrails na wykresie
workflow wpisu audytowego: na zielono, gdy krok przeszedł lub edytował, na
bursztynowo przy ostrzeżeniu lub błędzie fail-open, na czerwono przy blokadzie,
odpowiedzi lub błędzie fail-closed, a przyciemnia krok, który nigdy się nie
uruchomił. Opis pól znajdziesz w Pluginach.