

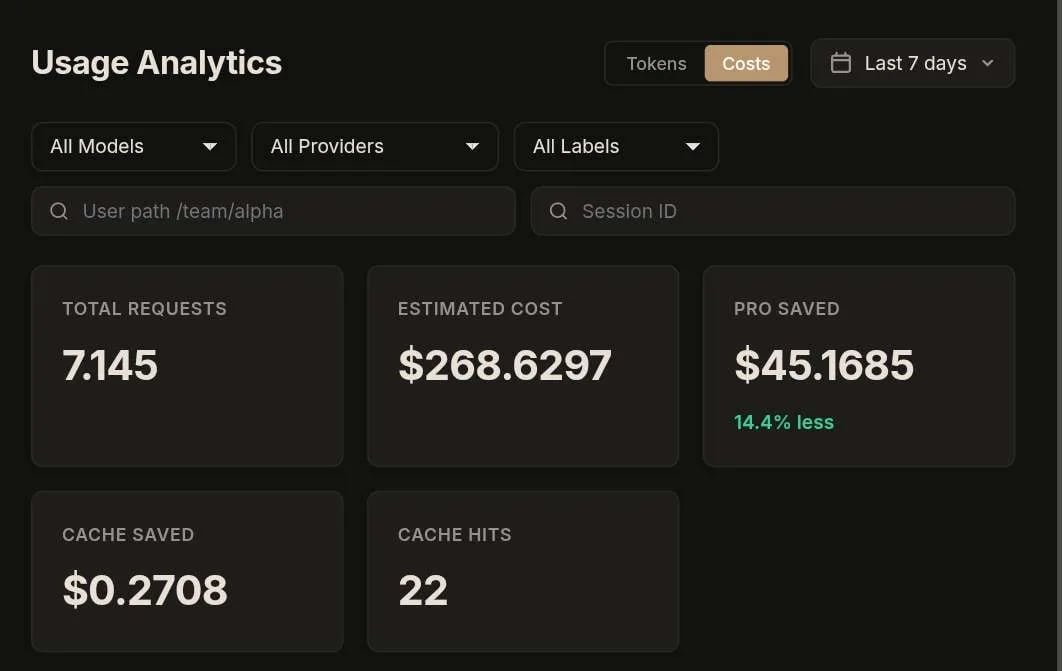
Strona Usage w dashboardzie: oszczędności Pro w ciągu siedmiu dni ruchu produkcyjnego.
Sprawdzone na produkcji
Kompresja promptów została przetestowana na miliardach tokenów produkcyjnych w agentowym kodowaniu, czacie i obciążeniach intensywnie korzystających z narzędzi.- Bezstratna. Kompresja jedynie zastępuje treść, którą model już widział w tym samym requeście, odwołaniem do niej albo odwracalnie przekodowuje dane strukturalne. Model otrzymuje te same informacje; nic nie jest streszczane ani usuwane. Jedyna stratna opcja, przycinanie wyników narzędzi, to osobna polityka, domyślnie wyłączona.
- Bez pogorszenia prompt cache. Ponieważ wcześniej wysłany prefiks sesji jest odtwarzany bajt w bajt, a przepisywane są tylko nowe wiadomości, prompt cache providera nadal trafia w kolejnych turach. Testerzy zauważyli wręcz około 2% wzrostu trafień w prompt cache, bo krótsze, stabilniejsze requesty lepiej mieszczą się w cache’u – co daje dodatkowe oszczędności ponad samą kompresję.
- Rzeczywiste oszczędności od 2% do 20% tokenów wejściowych u naszych testerów, zależnie od przypadku użycia. Agenty, które ponownie czytają pliki, odtwarzają wyniki narzędzi lub niosą długą historię, są na górze tego zakresu; krótki czat bez powtórzeń jest na dole, gdzie kompresor po prostu przekazuje requesty bez zmian.
- Pełna kontrola. Wybieraj poziom per gateway lub per request, wykluczaj
modele wzorcami glob, chroń istniejącą historię przez
new_messages_only, zachowuj kod źródłowy dosłownie i sprawdzaj każde przepisanie przez nagłówki odpowiedzi, rewizje audytu i metryki.
Przegląd
Kompresja promptów przepisuje obsługiwane requesty inferencji, zanim trafią do providera. Redukuje powtarzający się lub strukturalny kontekst, zachowując nietekstową strukturę requestu. ObsługujePOST /v1/chat/completions, POST /v1/messages i
POST /v1/responses. Argumenty wywołań narzędzi, części nietekstowe i nieznane pola
JSON pozostają nienaruszone. Elementy reasoning w Responses są zawsze odtwarzane
bez zmian, bo Responses API może ich wymagać obok wywołań funkcji.
Domyślna polityka high łączy deduplikację ciągów linii z normalizacją:
- marginesy z numerami linii z odczytu plików stają się zwięzłym nagłówkiem zakresu
- odtwarzany reasoning z chat completions jest usuwany, gdy jest to bezpieczne
- znane koperty wyników narzędzi, wyniki wyszukiwania, logi, JSON i ujednolicone diffy są normalizowane z uwzględnieniem treści
- opłacalne jednorodne tablice JSON i logi strukturalne używają odwracalnych, samoopisujących się kodowań
new_messages_only, gdy gateway może dołączyć do rozmowy, której
prefiksu nie obserwował.
Konfiguracja kompresji
Ustaw
PRO_COMPRESSION_LEVEL=none, aby wyłączyć kompresję dla całego
gatewaya. Dla pojedynczego requestu wyślij:
none pomijają parsowanie body requestu, więc
request jest przekazywany bez zmian.
Podgląd kompresji
Skompresowane odpowiedzi zawierają szacowane oszczędności i liczbę zastąpionych zduplikowanych bloków:LOGGING_LOG_BODIES=true. Metryki Prometheus używają
prefiksu gomodel_pro_compression_, a strona Usage w dashboardzie raportuje oszczędności Pro
w tokenach lub koszcie.