

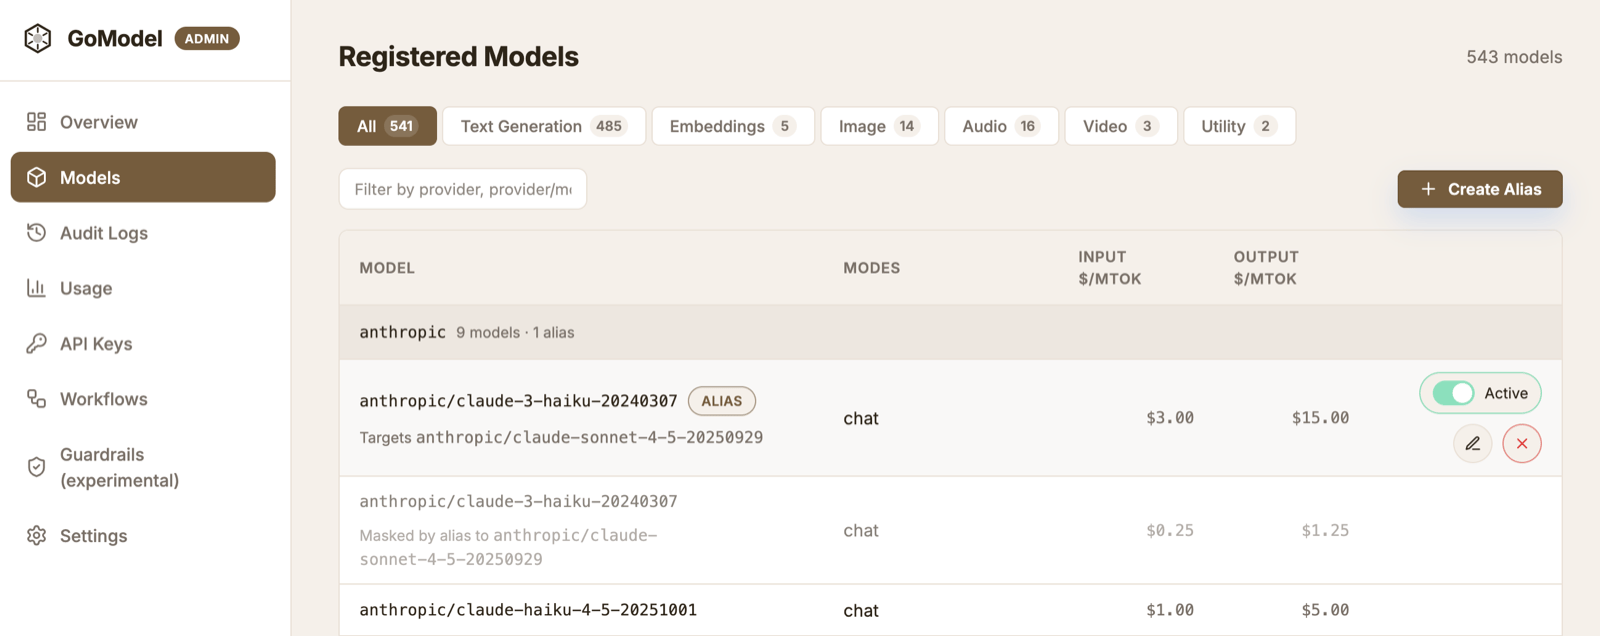
Co robią modele wirtualne
Model wirtualny to model, który definiujesz sam, a nie taki, który ogłasza provider. GoModel ustala jego rodzaj na podstawie tego, czy podasz cel:- Przekierowanie (alias) to stabilna nazwa wskazująca na konkretny model
providera. Twoja aplikacja wysyła tę nazwę w polu
model, a GoModel rozwiązuje ją przed wysłaniem requestu do upstreamu. - Polityka dostępu nie ma celu. Ogranicza istniejący selektor modelu według
user_path– albo całkowicie go wyłącza – bez dodawania nowej nazwy. Kontrolę dostępu opisuje strona Ścieżka użytkownika.
Models -> New virtual model.
Wypełnij Target model, aby utworzyć przekierowanie; zostaw puste, aby utworzyć politykę
dostępu dla selektora Source.
GoModel nie zapisuje pustych, nieskutecznych polityk dostępu, niezależnie od tego, czy są zapisywane
z dashboardu, czy przez admin API. Jeśli zapisana polityka nie ma celu, ścieżek
użytkownika, opisu ani spowolnienia, a jej stan włączenia odpowiada odziedziczonemu/domyślnemu
stanowi dostępu, GoModel usuwa zapisany wiersz. Zachowuje poza tym pustą
politykę, gdy ten wiersz nadal nadpisuje wyłączoną wartość domyślną lub odziedziczone
ograniczenie ścieżki użytkownika.
Dodawanie sztucznego opóźnienia modelu
Ustaw Slowdown na konkretnym modelu lub przekierowaniu, aby dodać ułamek zmierzonego czasu inferencji. Aktywne wartości mieszczą się w zakresie od0.1 do 10; na przykład 0.5
dodaje 50%, więc odpowiedź, która w upstreamie trwa 2 sekundy, zostanie zwrócona po około
3 sekundach. Ustaw 0, aby jawnie wyłączyć spowolnienie, w tym spowolnienie odziedziczone
z konkretnego modelu. Pozostawienie pustego pola oznacza, że ustawienie nie jest określone.
Opóźnienia respektują anulowanie requestu.
Dla odpowiedzi streamowanych – SSE w Chat Completions i Responses API oraz
endpointach audio – GoModel odczytuje upstream
w tle i zwalnia każdy odczytany chunk zgodnie z przeskalowaną osią czasu. Zachowuje to
względne odstępy czasowe chunków providera, a opóźnione chunki gromadzą się
w pamięci. Duży współczynnik przy długim lub intensywnym streamie albo przy dużej
odpowiedzi audio może więc zużywać sporo pamięci; na produkcji, gdzie nie ma to żadnego celu,
nie ustawiaj spowolnienia. Sesje Realtime przez WebSocket nie są spowalniane.
Gdy zarówno alias, jak i jego konkretny cel mają spowolnienie, wygrywa wartość
aliasu. Alias bez własnej wartości dziedziczy spowolnienie wybranego modelu docelowego;
ustaw w aliasie 0, aby nadpisać to dziedziczenie. Dotyczy to też
modeli wirtualnych z load balancingiem po wybraniu celu.
Reszta tej strony dotyczy przekierowań.
Używanie stabilnych nazw
Możesz udostępniać nazwy takie jakregular i smarter zamiast identyfikatorów
modeli specyficznych dla providera.
regular->anthropic/claude-sonnet-4-6smarter->anthropic/claude-opus-4-6
Load balancing między modelami
Przekierowanie może wskazywać kilka modeli docelowych i rozkładać między nie requesty. Dodaj w edytorze więcej niż jeden cel (Add target) i wybierz strategię:- Round-robin (domyślnie) rozkłada requesty równomiernie między cele. Ustaw
wagę poszczególnych celów, aby zmienić udział – cel z wagą
2dostaje dwa razy więcej ruchu niż cel z wagą1. - Lowest cost kieruje każdy request do najtańszego obecnie dostępnego celu, według ceny za token wejściowy + wyjściowy z rejestru modeli. Gdy cel nie ma cennika w rejestrze, jest pomijany, o ile istnieje cel z cennikiem; jeśli żaden nie ma cennika, używany jest pierwszy cel z listy.
- Failover zawsze kieruje do pierwszego obecnie dostępnego celu w kolejności z listy: cele tworzą listę priorytetów, a niższe pozycje obsługują ruch tylko wtedy, gdy każda pozycja powyżej jest niedostępna lub zawodzi. Wagi i utrzymywanie sesji nie mają zastosowania.
- Adaptive (GoModel Pro) wybiera cel o najlepszym obserwowanym opóźnieniu, odsetku błędów i cenie, wycofuje się z celów objętych limitem żądań lub zawodzących i utrzymuje sesję u providera, którego prompt cache jest rozgrzany. Zobacz Inteligentny routing. W buildzie open source ta strategia przechodzi na round-robin.
- Plugin (
strategy: plugin) deleguje wybór do załadowanego pluginu strategii routingu wskazanego przezstrategy_plugin, konfigurowanego per przekierowanie przezstrategy_config. Wbudowanycheapest_healthypreferuje najtańszy (lub najszybszy) cel, którego niedawny odsetek błędów jest akceptowalny. Wagi nie mają zastosowania; jeśli plugin zawiedzie lub go brakuje, przekierowanie przechodzi na ważony round-robin.
user_path nie może używać: każda strategia go omija,
więc wyłączenie modelu (na przykład gdy wyczerpał się limit u jego providera)
przenosi jego ruch na pozostałe cele, dopóki go ponownie nie włączysz. Gdy każdy
dostępny cel jest wyłączony lub zabroniony, request kończy się błędem
model_access_denied; gdy żaden cel nie jest w ogóle dostępny (nieznany model,
provider nie działa), nazwa jest rozwiązywana jak każda inna nazwa modelu, zwykle
kończąc się błędem „model not found”. Request, który bezpośrednio wskazuje wyłączony model,
nadal kończy się błędem.
Przekierowanie z jednym celem zachowuje się dokładnie jak zwykły alias.
Niezależnie od strategii pozostałe cele tworzą łańcuch failoveru
przekierowania: gdy wybrany cel zawiedzie z błędem kwalifikującym się do ponowienia, request jest
ponawiany na pozostałych dostępnych celach w kolejności z listy. Pole wyboru
Failover w edytorze (domyślnie włączone; failover: false w kodzie) wyłącza to
dla jednego przekierowania, więc nieudany request otrzymuje w odpowiedzi błąd;
można je też wyłączyć globalnie lub przez workflow requestu. Zobacz
Failover, aby poznać błędy, które wywołują ponowienie, i dowiedzieć się, jak
dodać łańcuch failoveru do prawdziwego modelu przez jego przesłonięcie.
Requesty należące do jednej wykrytej sesji klienta trzymają się celu, który
obsłużył sesję jako pierwszy (Session keeping, domyślnie włączone), dzięki czemu
rozmowy zachowują rozgrzany prompt cache providera między turami. Odznacz pole
Session keeping w edytorze (lub ustaw session_affinity: false), aby
przywrócić bezstanowe równoważenie – zobacz
Utrzymywanie sesji.
smart jednocześnie na openai/gpt-4o i anthropic/claude-sonnet-4-6
ze strategią round-robin, aby rozłożyć obciążenie, albo na model premium i budżetowy
ze strategią kosztową, aby zawsze wybierać tańszy.
Zmiana kolejności celów
Lista celów jest uporządkowana, a edytor pozwala ją zmieniać: przeciągnij uchwyt (☰) przy lewej krawędzi wiersza celu na inny wiersz, aby zmienić jego pozycję. Wiersz docelowy nie jest zastępowany – przeciągany wiersz trafia na jego pozycję, a wiersze pomiędzy się przesuwają. Użytkownicy klawiatury mogą ustawić fokus na uchwycie i nacisnąć ArrowUp / ArrowDown, aby wykonać to samo przesunięcie. Uchwyt jest widoczny tylko wtedy, gdy przekierowanie ma więcej niż jeden cel, a korzysta na tym każda strategia: dla failover kolejność to łańcuch priorytetów (pozycja1 jest próbowana jako pierwsza), dla strategii równoważących pozycja 1 to pierwsze
miejsce w kolejce. Wagi i jawne przypięcia do providera pozostają przy swoim
celu, gdy jest przesuwany.
Łączenie modeli wirtualnych w łańcuchy
Cel przekierowania może wskazywać inny model wirtualny zamiast konkretnego modelu. Wewnętrzny model wirtualny jest rozwiązywany w momencie requestu, więc jego cele, wagi i strategia są zdefiniowane raz i używane wszędzie, gdzie się do niego odwołujesz – bez duplikowanych list celów, które z czasem się rozjeżdżają.- Strategia kosztowa wycenia gałąź z łańcucha według najtańszego konkretnego modelu obecnie dostępnego za nią.
- Model wirtualny w łańcuchu, który jest wyłączony lub nie ma dostępnego celu, jest pomijany jak niedostępny model providera.
- Do requestu stosowane są tylko
user_pathsislowdownzewnętrznego modelu wirtualnego; zakres wewnętrznego nie jest sprawdzany, gdy dochodzi się do niego przez łańcuch. /v1/modelswypisuje przekierowanie z łańcuchem z metadanymi jego pierwszego dostępnego konkretnego modelu.
config.yaml, dashboard czy admin API – więc team/cheap trafia do
modelu wirtualnego o tej nazwie, mimo że wygląda jak provider/model. Ustaw
provider jawnie ({ provider: groq, model: llama-3.3-70b }), aby przypiąć
cel do konkretnego modelu niezależnie od modelu wirtualnego o tej samej nazwie.
Przekierowanie, które przesłania prawdziwy model i wymienia ten model
wśród własnych celów (taki kształt tworzy strona Models, gdy dodajesz
fallbacki lub równoważenie do modelu), obejmuje model, a nie go zastępuje.
Alias lub dowolne inne przekierowanie wskazujące ten model łączy się w łańcuch z tym obejmującym
przekierowaniem, więc dostaje to samo równoważenie i failover co bezpośredni request – z jednym
wyjątkiem: odwołanie fallbackowe jednego takiego obejmującego przekierowania do innego objętego modelu
trafia do samego modelu, a nie do listy fallbacków tamtego przekierowania. Dzięki temu
dwa modele mogą się wzajemnie chronić bez tworzenia cyklu, a fallback nie
pociąga za sobą fallbacków fallbacku. Ponieważ samo odwołanie do objętego modelu
wskazuje model, a nie obejmujące go przekierowanie, takie przekierowanie
można usunąć, gdy takie odwołania istnieją – po prostu wracają one do
konkretnego modelu. Przesłonięcie, które nie wymienia swojego źródła, zastępuje model
i działa w łańcuchu jak każdy inny model wirtualny: odwołania łączą się z
jego celami, a nie można go usunąć ani zmienić jego nazwy, dopóki nie zostaną przekierowane.
Łańcuchy muszą być acykliczne (a -> b -> a jest odrzucane z wypisanym cyklem)
i mieć głębokość co najwyżej 8 modeli wirtualnych. Obie reguły są egzekwowane przy zapisie
z dashboardu i przy starcie dla wpisów deklaratywnych. Cel musi istnieć w momencie
zapisu – najpierw utwórz wewnętrzny model wirtualny – a modelu wirtualnego, przez który
przechodzą inne łańcuchy, nie można usunąć ani zmienić jego nazwy, dopóki nie zostaną przekierowane.
Zmiana nazwy lub celu przekierowania
Otwórz przekierowanie w dashboardzie i edytuj jego Source, aby zmienić nazwę. GoModel przenosi definicję pod nową nazwę w jednym kroku – stara nazwa przestaje być rozwiązywana, więc zaktualizuj każdą aplikację, która nadal jej używa. Zmiana nazwy na taką, która już należy do innego modelu wirtualnego, jest odrzucana; zmiana nazwy na nazwę konkretnego modelu przesłania ten model (zobacz Przesłanianie modelu). Przekierowania przesłaniające model można edytować w ten sam sposób – użyj akcji Edit redirect w wierszu modelu. Modele wirtualne zadeklarowane w kodzie mająsource
ustalone w konfiguracji; zmień ich nazwę, edytując deklarację.
Definiowanie modeli wirtualnych w kodzie
Operatorzy, którzy zarządzają konfiguracją jako infrastructure-as-code, mogą deklarować modele wirtualne wconfig.yaml lub w zmiennej środowiskowej VIRTUAL_MODELS zamiast w
dashboardzie. Wpisy deklaratywne są stosowane przy starcie, nadpisują każdy
wiersz w magazynie admina z tym samym source i są pokazywane w dashboardzie tylko do odczytu
(z oznaczeniem Config). Aby je zmienić, edytuj konfigurację.
W config.yaml:
config.yaml o pasującym source:
source, pojedynczy target (skrót) lub listę targets,
strategy (round_robin, cost lub failover), session_affinity (domyślnie true; zobacz
Utrzymywanie sesji), failover (domyślnie true; zobacz
Failover), user_paths, description,
slowdown (0 wyłącza odziedziczone spowolnienie; aktywne współczynniki mieszczą się w zakresie od 0.1 do
10) oraz enabled.
model celu może wskazywać inny zadeklarowany model wirtualny (zobacz
Łączenie modeli wirtualnych w łańcuchy).
Zostaw cele puste, aby zadeklarować politykę dostępu dla selektora source.
Nieprawidłowa deklaracja (nieznana strategia, brakujący lub odwołujący się do samego siebie cel,
cykl w łańcuchu lub łańcuch głębszy niż 8 modeli wirtualnych albo provider celu, który
nie pasuje do żadnego skonfigurowanego providera – literówka) powoduje błąd startu z czytelnym komunikatem
wypisującym nazwy zarejestrowanych providerów.
Dwa łagodne wyjątki pozwalają poprawnym konfiguracjom się uruchomić:
providercelu, który jest zadeklarowany wproviders:, ale się nie zarejestrował – zwykle dlatego, że jego dane uwierzytelniające nie są ustawione w tym środowisku – powoduje tylko ostrzeżenie w logach; cel pozostaje niedostępny, dopóki dane uwierzytelniające nie zostaną rozwiązane.config.yamlwspółdzielony między środowiskami nadal wszędzie się uruchamia.- To, czy model celu istnieje, nigdy nie jest sprawdzane przy starcie: katalog modeli ładuje się asynchronicznie, więc dostępność jest kwestią runtime’u, a niedostępny cel jest po prostu pomijany w momencie rozwiązywania.
Domyślna dostępność modeli
Każdy model providera jest dostępny, chyba że wpis wvirtual_models stanowi
inaczej. Aby odwrócić to domyślne zachowanie, ustaw:
targets – działa jak czysta
reguła dostępu (enabled: true, opcjonalnie z user_paths). Requesty do niedostępnych
modeli kończą się błędem 400 model_access_denied, a modele te nie pojawiają się w
GET /v1/models. Przekierowanie jest rozwiązywane według własnej flagi enabled, ale jego
cel jest walidowany jak przy bezpośrednim wywołaniu: przy wyłączonej wartości domyślnej daj
modelowi docelowemu również własny wpis dostępu. Gdy ten cel jest jednocześnie źródłem
innego przekierowania, użyj zamiast tego polityki dla całego providera lub całego modelu: wpis
dostępu dla tego źródła zastępuje przekierowanie zarządzane z dashboardu.
To nie jest odwrotność udostępniania tylko przekierowań:
tamto ustawienie zmienia tylko to, co wypisuje GET /v1/models, natomiast domyślna
dostępność decyduje, które modele requesty w ogóle mogą wywoływać.
Udostępnianie tylko przekierowań
Aby ukryć modele providerów wGET /v1/models, ustaw:
/v1/models włączone przekierowania
zamiast pełnej listy modeli providerów. Ustawienie jest też wymienione w
.env.template.
Wypisywanie samych identyfikatorów modeli
DomyślnieGET /v1/models zwraca identyfikatory kwalifikowane providerem, takie jak
openai/gpt-5. Niektórzy klienci walidują skonfigurowany model względem tej listy
i znają tylko proste nazwy, więc nigdy nie znajdują dopasowania. Aby zamiast tego wypisywać same identyfikatory, ustaw:
owned_by nadal zawiera nazwę providera. Requesty o sam identyfikator modelu
działają tak samo w obu trybach.
Zastrzeżenie: gdy dwóch providerów udostępnia ten sam identyfikator modelu (na przykład gpt-5
zarówno w openai, jak i w azure), wypisywany jest tylko provider, do którego trafia
niekwalifikowany request (pierwszy zarejestrowany). Aby przypiąć nazwę do konkretnego providera, dodaj
model wirtualny z tą nazwą jako źródłem:
Przesłanianie modelu
Przekierowanie może „przesłonić” model, używając tej samej nazwy co istniejący model i kierując ruch gdzie indziej. Pozwala to nadpisać żądany model bez zmiany kodu aplikacji. Na przykład:- source:
anthropic/claude-opus-4-6 - target model:
anthropic/claude-sonnet-4-6
anthropic/claude-opus-4-6, a GoModel kieruje
request do anthropic/claude-sonnet-4-6.
Testy A/B
Przekierowania przydają się do krótkich eksperymentów z modelami. Przenieś przekierowanie z jednego celu na inny, a następnie porównaj zachowanie aplikacji, opóźnienia i użycie. Na przykład skierujsmarter na Opus w jednym teście i na Sonnet w innym. Możesz
też przesłonić opus-4-6 modelem sonnet-4-6, aby sprawdzić, czy ten sam przepływ aplikacji nadal
działa.