

Przegląd
Limity żądań ograniczają tempo requestów, tempo zużycia tokenów i współbieżność requestów w toku. Każda reguła ma zakres (scope), który określa, co chroni:- Ścieżka użytkownika (kontrola konsumentów) — np.
/team/alphamoże wysłać100requestów na minutę, zużyć50,000tokenów na minutę i mieć10requestów w toku, łącznie dla wszystkiego pod tą ścieżką. - Provider (ochrona upstreamu) — np. wysyłaj do providera
openainajwyżej500requestów na minutę łącznie od wszystkich konsumentów i dla wszystkich modeli, aby gateway nigdy nie przekroczył Twojego limitu u providera. - Model — np.
openai/gpt-4omoże zużyć90,000tokenów na minutę; samo id, takie jakgpt-4o, ogranicza model u wszystkich providerów.
429 z błędem w kształcie OpenAI, dokładnym nagłówkiem Retry-After oraz
nagłówkami x-ratelimit-* — zmiana modelu by nie pomogła, bo to konsument jest
przedmiotem limitu. Nasycony provider lub model jest natomiast traktowany jak
niedostępny cel: load balancing i failover modeli wirtualnych omijają go,
dopóki inny cel ma wolną przepustowość, i dopiero gdy nie pozostaje żaden
możliwy cel, klient dostaje 429.
Limity obowiązują na każdym endpointcie modeli: chat completions, responses, messages,
embeddingi, audio, passthrough, sesje realtime i wysyłanie batchy.
Używaj limitów żądań do kontroli ruchu, a budżetów do kontroli wydatków: budżety ograniczają
dolary w horyzoncie od godzin do miesięcy na podstawie trwałych rekordów użycia, a limity żądań
ograniczają tempo requestów i tokenów w horyzoncie od sekund do doby za pomocą szybkich liczników w pamięci.
Włączanie limitów żądań
Limity żądań są domyślnie włączone i nic nie kosztują, dopóki nie istnieją żadne reguły:max_tokens) są liczone na podstawie rekordów użycia, więc wymagają
śledzenia użycia:
Tworzenie limitów żądań
W dashboardzie: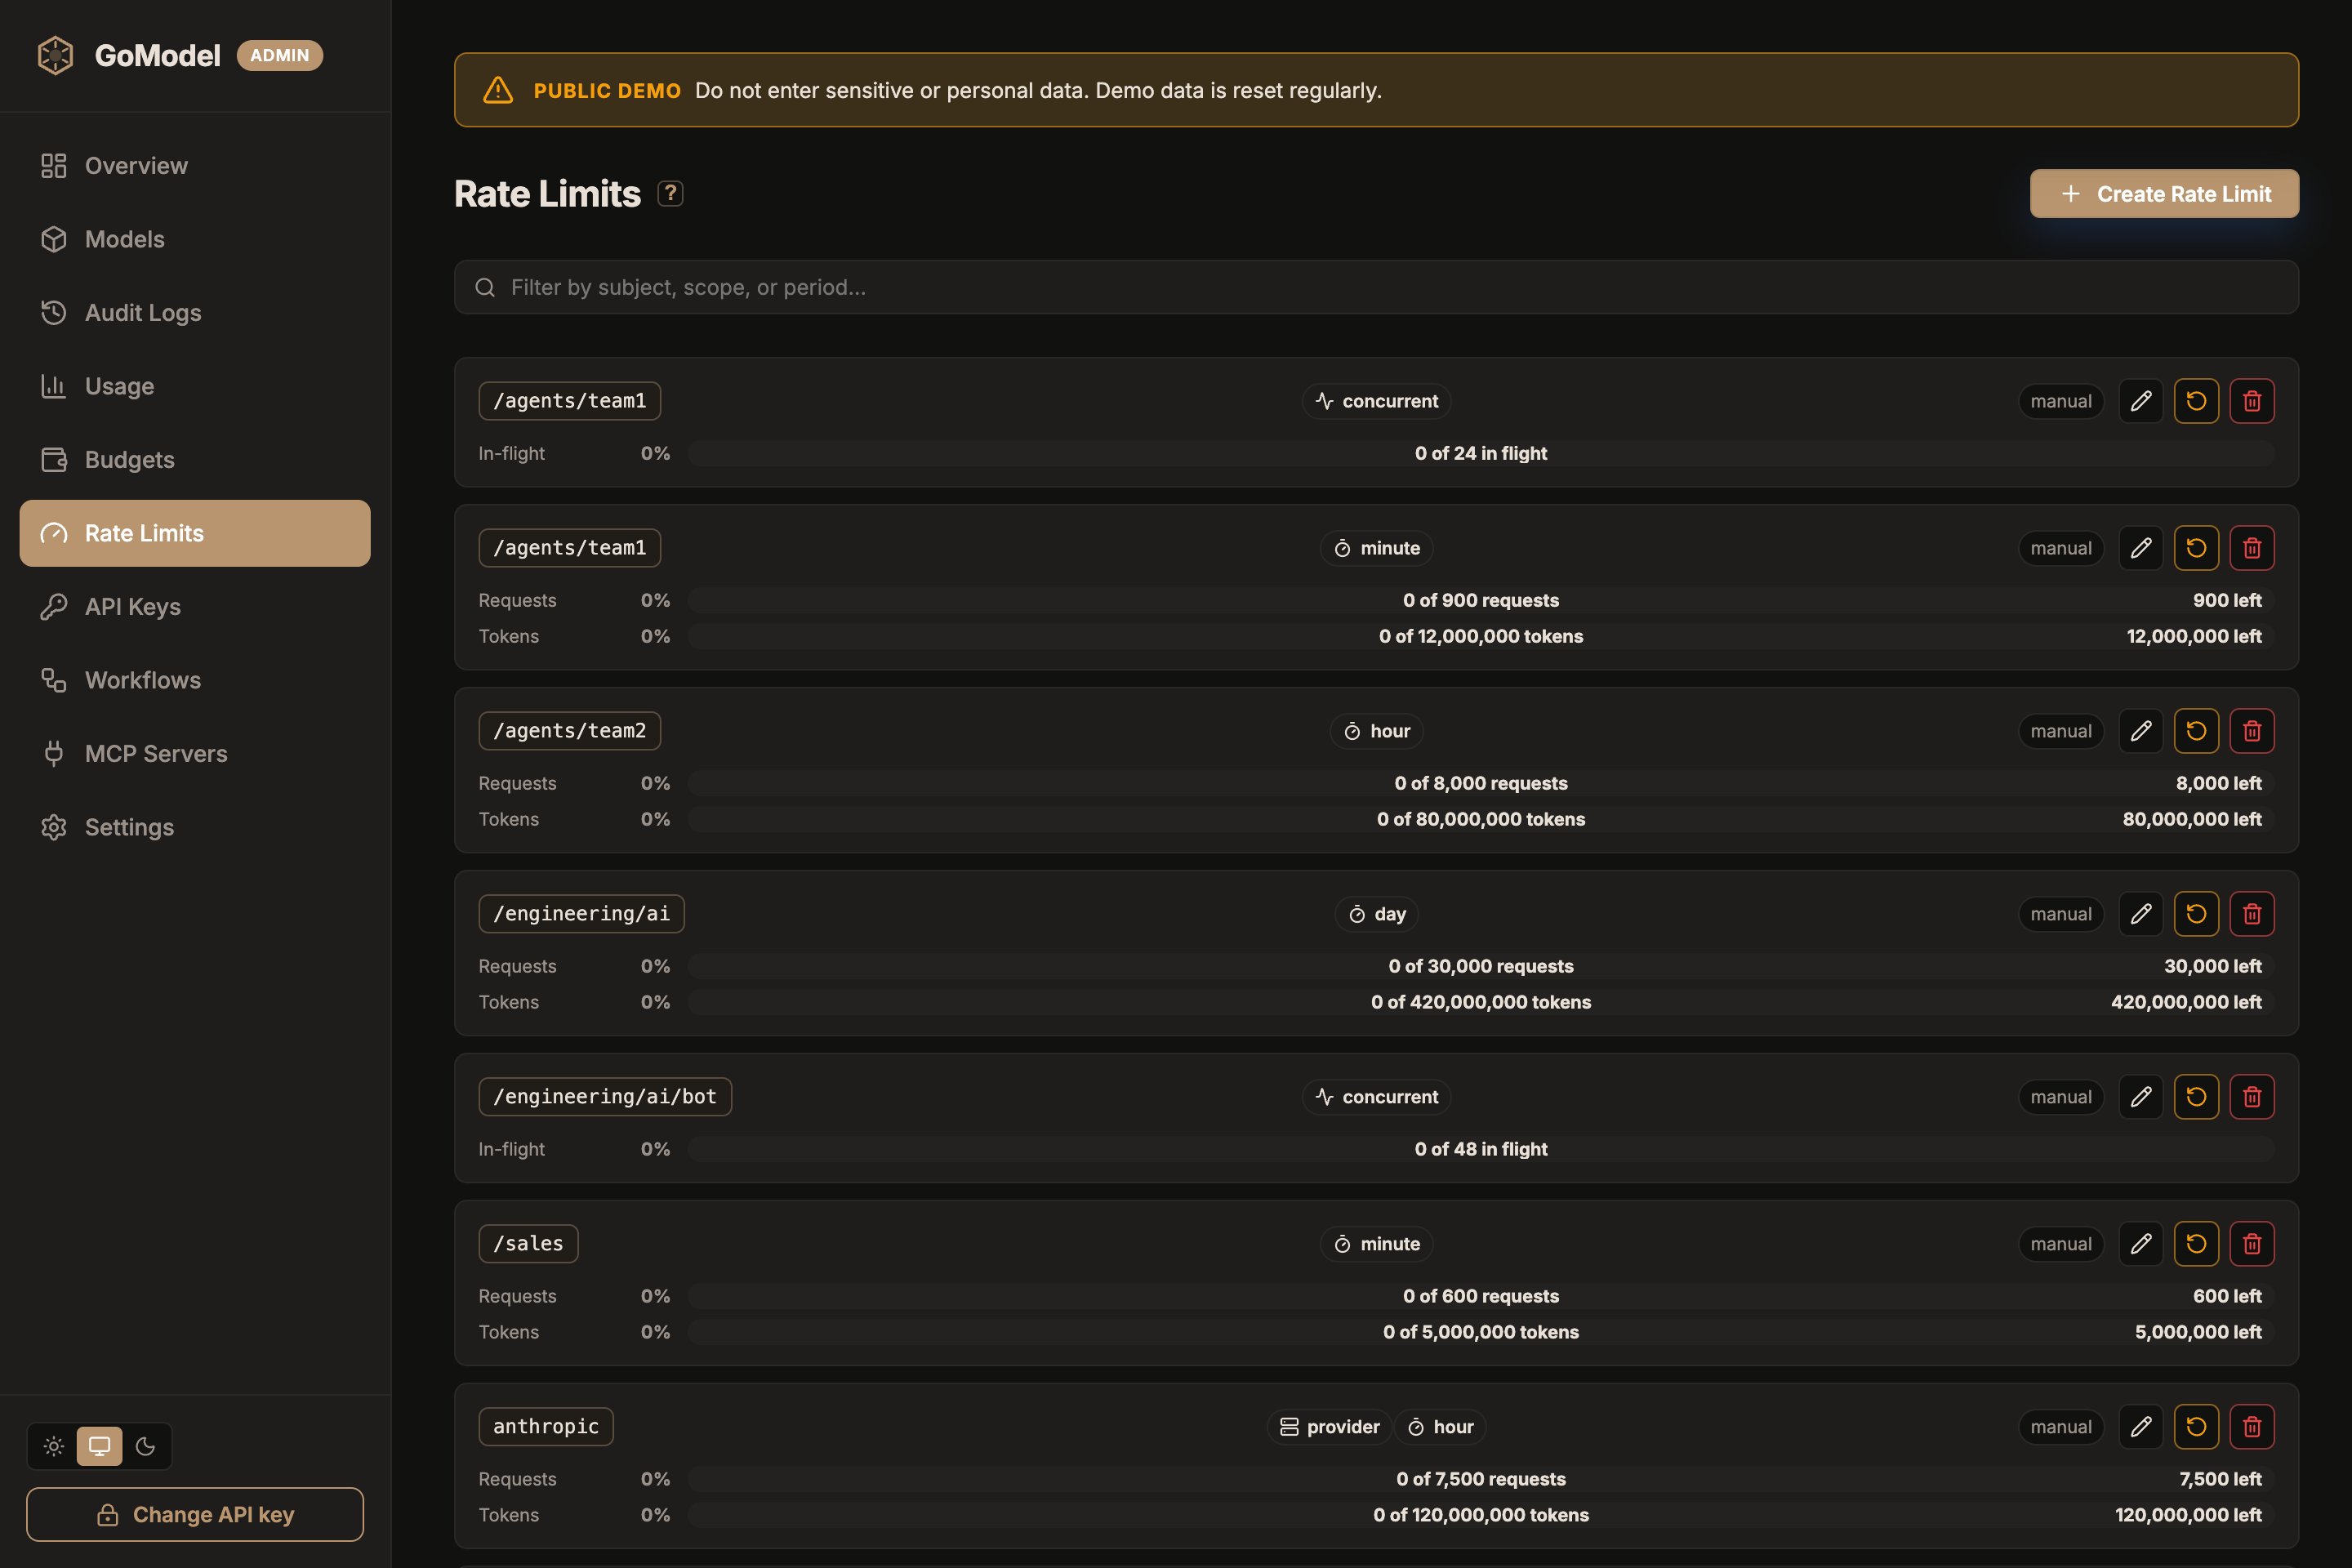
manual. Reguły wczytane z YAML lub
zmiennych środowiskowych są oznaczone jako config i w dashboardzie są tylko do odczytu.
Każdy wiersz pokazuje bieżące użycie względem limitu; ikona resetu czyści liczniki tylko tej
reguły, a ikona kosza usuwa regułę (co również ją resetuje).
Strona Models ma przy każdym wierszu modelu i nagłówku providera przycisk ze wskaźnikiem, który
otwiera te same limity dla danego podmiotu w kontekście: własne reguły modelu, współdzielone
reguły providera i reguły globalne (dla głównej ścieżki użytkownika) — każdą z
bieżącym użyciem — oraz akcje dodawania i edycji.
Edycja zakresu, podmiotu lub okresu reguły przenosi ją: reguła jest tworzona na nowo
pod nowym kluczem, a jej bieżące liczniki startują od nowa. Edycja samych limitów zachowuje
liczniki.
Zainicjuj reguły z YAML:
SET_RATE_LIMIT_<PATH>
(sufiks jest mapowany na ścieżkę użytkownika dokładnie tak jak w SET_BUDGET_*; __ oddziela
segmenty ścieżki); reguły providerów używają SET_PROVIDER_RATE_LIMIT_<NAME>
(podkreślenia zamieniają się w myślniki, tak jak w zmiennych środowiskowych instancji providerów):
rpm/tpm na minutę, rph/tph na godzinę,
rpd/tpd na dobę, a concurrent to limit requestów w toku. Dla niestandardowych okien
akceptowana jest też tablica JSON z obiektami reguł:
Niestandardowe okna używają bezpośrednio
period_seconds.
Jak działa dopasowywanie i zliczanie
Ścieżki reguł obejmują skonfigurowaną ścieżkę i jej potomków, dokładnie tak jak budżety: reguła na/team pasuje do /team/app, ale nie do /team-alpha. Reguła
na / obejmuje cały ruch.
Reguły providerów dopasowują rozwiązaną instancję providera po nazwie. Reguły modeli
dopasowują faktycznie wykonany model: podmiot z kwalifikatorem providera (openai/gpt-4o)
obejmuje model jednego providera, a sam podmiot (gpt-4o) obejmuje ten model u
dowolnego providera. Dopasowanie nie rozróżnia wielkości liter, a reguła zachowuje pisownię,
w jakiej ją zapisano — reguła dla providera openai-EU jest wyświetlana i raportowana jako
openai-EU, a jednocześnie pasuje do trasy niezależnie od wielkości liter.
Reguła ma jeden wspólny licznik dla całego swojego podmiotu. Reguła 100 rpm na
/team pozwala na 100 requestów na minutę łącznie dla wszystkiego pod /team;
reguła 500 rpm na providerze openai jest współdzielona przez wszystkich konsumentów
i modele tam kierowane. Aby uzyskać limity per klucz, powiąż każdy zarządzany klucz API z jego
własną ścieżką użytkownika i zdefiniuj reguły dla tej ścieżki.
Dynamiczne limity żądań dla ścieżek podrzędnych są dostępne w GoModel Pro i wymagają
uprawnienia licencyjnego
quota_templates. Bez niego zapisy przez Admin API są
odrzucane z kodem 403 quota_templates_not_entitled, a per_child: true w
konfiguracji przerywa start — GoModel nigdy po cichu nie wraca do jednego
wspólnego licznika dla poddrzewa, ponieważ zmieniłoby to semantykę egzekwowania.per_child: true we wpisie ścieżki użytkownika, aby zamienić go w dynamiczny szablon.
Każda bezpośrednia ścieżka podrzędna ma wtedy niezależne liczniki: przy szablonie na
/customers ścieżka /customers/alice/app współdzieli licznik /customers/alice, a
/customers/bob dostaje osobny. Sama ścieżka szablonu /customers nie jest
dopasowywana. Reguły providerów i modeli nie mogą działać per ścieżka podrzędna.
Globalna lista administracyjna pokazuje szablon per child bez mylącego
zagregowanego licznika. GET /v1/usage rozwiązuje szablon dla ścieżki użytkownika
wywołującego i zwraca bieżące liczniki tej ścieżki podrzędnej. Zresetowanie lub usunięcie szablonu
czyści wszystkie okna requestów i tokenów ścieżek podrzędnych dla tej definicji; aktywne
sloty współbieżności zwalniają się normalnie, gdy ich requesty się zakończą.
Sprawdzane są wszystkie pasujące reguły; pierwszy wyczerpany limit odrzuca request.
Limity providerów i modeli omijają nasycenie
Nasycony provider lub model zachowuje się jak taki z nieaktualnym inwentarzem:- Load balancing modeli wirtualnych pomija nasycony cel i wybiera
następny dostępny, więc alias z kilkoma celami nadal obsługuje ruch. Gdy
wszystkie cele są nasycone, alias i tak rozwiązuje się do pierwszego celu, aby
klient dostał rzetelne
429zRetry-After(albo przejął failover), a nie błąd niedostępnego modelu, a alias przez cały czas pozostaje widoczny w/v1/models. - Łańcuch failoveru przejmuje obsługę nasyconej trasy głównej: główny provider nigdy nie jest wywoływany (chętnie obsłużyłby request i zniweczył limit), przeglądanie pozostałych celów przekierowania zaczyna się natychmiast, a kandydaci nasyceni limitem żądań są po drodze pomijani.
- Requesty bezpośrednie bez modelu wirtualnego dostają
429z rzetelnymRetry-After— tę samą odpowiedź, którą prędzej czy później dałby sam provider, ale bez zbędnego wywołania upstreamu. Przekroczenia po stronie konsumenta (ścieżki użytkownika) zawsze zwracają429: zmiana celu nie może ich złagodzić.
- Okna requestów używają estymacji okna przesuwnego, więc skoki ruchu nie mogą się podwoić na granicach okien.
- Użycie tokenów jest liczone po zakończeniu każdej odpowiedzi (także streamów). Jeden request może przekroczyć okno tokenów, zanim licznik nadąży — tak samo jak w innych gatewayach, które liczą tokeny na podstawie odpowiedzi.
- Trafienia w cache odpowiedzi są serwowane przed egzekwowaniem limitów i niczego nie zliczają.
- Sesja realtime liczy się jako jeden request i zajmuje jeden slot współbieżności przez całą sesję. Wysłanie batcha liczy się jako jeden request i nie zajmuje slotu współbieżności.
- Okna requestów i tokenów są przechowywane w pamięci na potrzeby przyjmowania requestów, a ich snapshot jest zapisywany
w skonfigurowanym storage mniej więcej raz na sekundę (i przy zamykaniu), więc
przetrwają restart i
gomodel --reload. Wskaźniki współbieżności nie są utrwalane: po restarcie nic nie jest w toku. Przy N replikach efektywny limit nadal wynosi około N razy skonfigurowana wartość — do trwałej kontroli między instancjami używaj budżetów. Interwał snapshotów dostroisz zmiennąRATE_LIMITS_FLUSH_INTERVAL(w sekundach; domyślnie1;0pomija okresowy zapis, ale nadal wczytuje dane przy starcie i zapisuje je przy czystym zamknięciu).
Zachowanie klienta
Requesty ponad limit otrzymują:429 i nagłówkiem Retry-After zawierającym liczbę sekund do chwili, gdy
ponowienie zostałoby faktycznie przyjęte w ramach okna przesuwnego (co może wykraczać
poza następną granicę okna). SDK OpenAI automatycznie wycofują się (back off) przy takim
kształcie odpowiedzi.
Przekroczenie niesie też nagłówki x-ratelimit-* dla limitu, który został
osiągnięty: limit/remaining/reset dla okna requestów lub tokenów.
Przekroczenie współbieżności wysyła x-ratelimit-limit-requests i
x-ratelimit-remaining-requests (zawsze 0), ale bez
x-ratelimit-reset-requests: wskaźnik requestów w toku nie ma okna do zresetowania —
slot zwalnia się, gdy request się kończy, i to właśnie szacuje Retry-After.
Udane odpowiedzi na ścieżkach objętych limitami zawierają nagłówki w stylu OpenAI z
najbardziej restrykcyjnej pasującej reguły:
Admin API
user_path to skrót od
"scope": "user_path", "subject": ...):
POST /admin/rate-limits/reset-one z
{"scope": ..., "subject": ..., "period": ...}) lub wszystkich reguł
(POST /admin/rate-limits/reset z {"confirmation": "reset"}). Edycja
reguły nigdy nie resetuje jej liczników; usunięcie reguły je resetuje.
Listę endpointów znajdziesz w Endpointach administracyjnych.