

Jak szacowane są koszty
Dla każdego requestu GoModel wycenia:- Tokeny wejściowe i wyjściowe według stawek modelu za milion tokenów (MTok).
- Tokeny wejściowe z cache’u, reasoningowe i audio według ich własnych stawek, gdy provider je raportuje, dzięki czemu ruch intensywnie korzystający z cache’u i reasoningu jest wyceniany poprawnie.
- Jednostki inne niż tokeny tam, gdzie provider w nich rozlicza: wygenerowane obrazy (
per_image/output_image_per_mtok), czas trwania audio (per_second_input,per_second_output) oraz znaki mowy (per_character_input). Która jednostka dotyczy którego modelu, opisują strony o obrazach i audio – gdy stawka jednostkowa i stawka tokenowa to dwa wyrażenia tej samej opłaty (wygenerowane tokeny obrazu, czas trwania klipu audio), stosowana jest tylko jedna z nich.
cost_in_usd_ticks w xAI), GoModel używa tej wartości zamiast cennika z katalogu. Każdy wiersz zapisuje użytą metodę w polu cost_source: model_pricing, openrouter_credits lub xai_cost_in_usd_ticks.
Tokeny z cache’u są tańsze tylko wtedy, gdy cennik modelu zawiera stawkę
cached_input_per_mtok. Bez niej są wyceniane według pełnej stawki wejściowej.cache_write_per_mtok, a 1-godzinne ("ttl": "1h") według cache_write_1h_per_mtok. GoModel wycenia każdą część według jej własnej stawki na podstawie podziału z usage.cache_creation. Bez stawki cache_write_1h_per_mtok zapisy 1-godzinne są wyceniane według cache_write_per_mtok.
Ceny zależne od pory dnia
Niektórzy providerzy naliczają różne stawki w zależności od tego, kiedy request jest wykonywany. Na przykład DeepSeek rozlicza godziny poza szczytem po połowie stawek szczytowych, a weekendy traktuje jako czas poza szczytem. Katalog publikuje standardowe (szczytowe) stawki jako ceny bazowe modelu i wymienia okresy ze zniżką wpricing.time_windows:
start włącznie, end wyłącznie); end równe lub wcześniejsze niż start przechodzi przez północ, a days ogranicza zakres do wybranych dni tygodnia (gdy pominięte – wszystkie dni). Stawki nieobecne w oknie zachowują cenę bazową, a poza wszystkimi oknami obowiązują ceny bazowe. Przeliczanie zapisanych kosztów korzysta z zapisanego znacznika czasu każdego wiersza, więc historyczne wiersze są wyceniane ponownie według okna, w które faktycznie wypadły. Szacunek kosztu wejścia z cache’u w dashboardzie stosuje okna z dokładnością do minuty tygodnia, zgodnie z precyzją granic okien.
Na stronie Models gwiazdka * obok ceny oznacza model z oknami czasowymi; najedź na nią, aby zobaczyć harmonogram i stawki. Nadpisanie stawki bazowej (input, output, cached input lub cache write) zastępuje również zniżkę z katalogu dla tej stawki: nadpisana wartość staje się ceną o każdej porze. Metadane modelu w config.yaml mogą też deklarować własne time_windows, które zastępują te z katalogu.
Okna czasowe to wyłącznie cykliczne harmonogramy w UTC. Reguły, których katalog
nie potrafi wyrazić – święta providera czy promocje ze stałą datą zakończenia – nie
są stosowane.
Skąd pochodzi cennik
Cennik modelu jest ustalany według priorytetu:- Nadpisania operatora ustawione w dashboardzie.
- Metadane
config.yamlwproviders.<name>.models. - Katalog modeli, pochodzący z rejestru
ai-model-list.
ai-model-list i zgłoś tam poprawkę albo ustaw nadpisanie, aby od razu to naprawić.
Cennik to jeden z elementów szerszego pipeline’u metadanych, który ustala też okna kontekstu, możliwości i kategorie modeli – pełny łańcuch źródeł opisuje strona Metadane modeli.
Nadpisywanie cennika
Nadpisz cennik, gdy cena z katalogu jest błędna, jej brakuje albo różni się od wynegocjowanej przez Ciebie stawki. Otwórz stronę Models, znajdź model i otwórz jego edytor Pricing override. Ustaw jeden lub więcej typów cen (input, output, cached input itd.) w USD. Zapisane pola nadpisują cennik z katalogu i zconfig.yaml dla danego selektora; nieustawione pola nadal są dziedziczone.
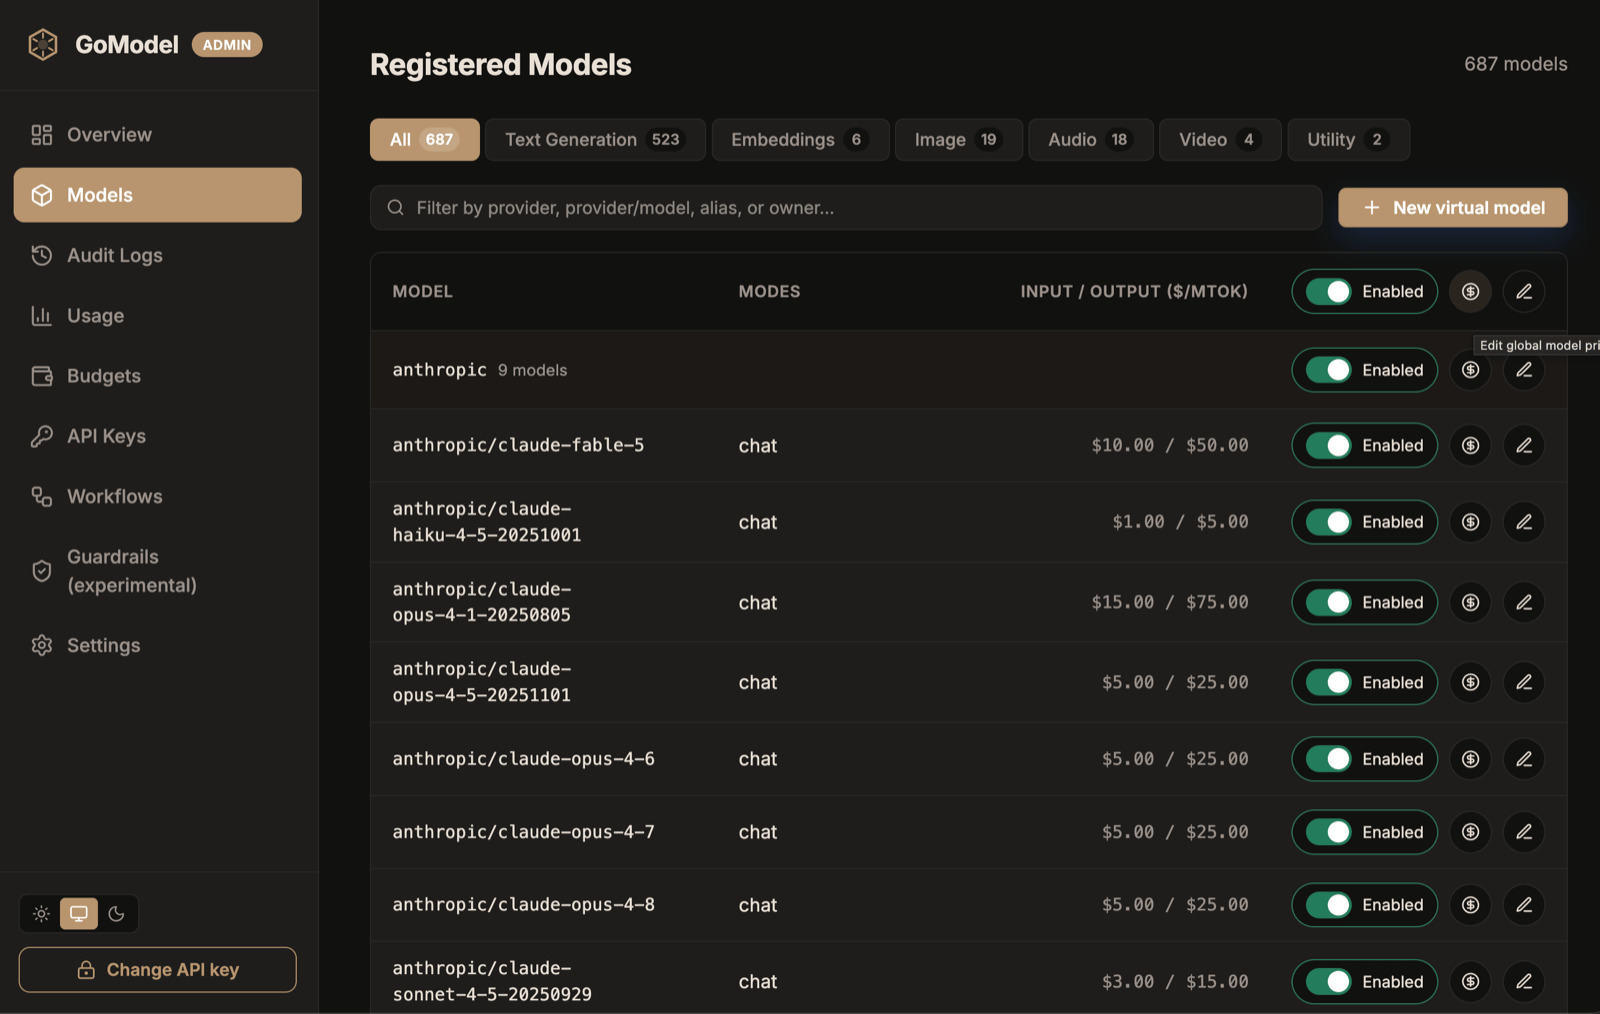
Strona Models pokazuje ceny każdego modelu; akcja $ otwiera nadpisanie cennika
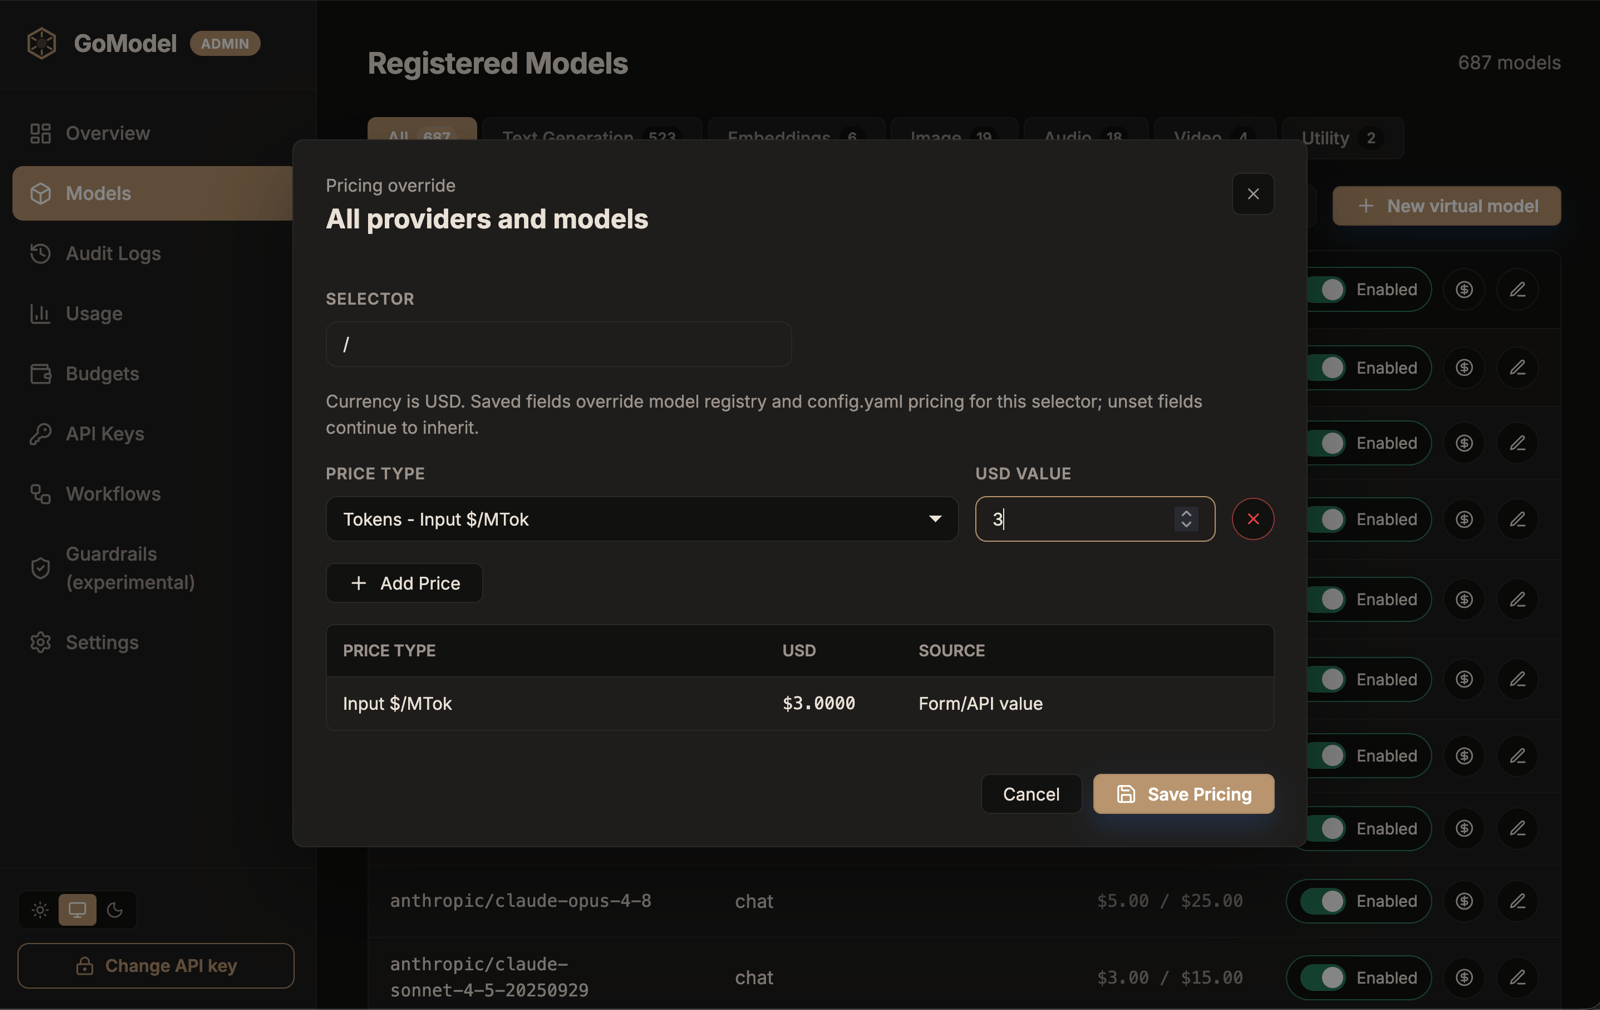
Ustaw typ ceny i wartość w USD; zapisane pola nadpisują cennik z katalogu i z config.yaml dla selektora
Sumy w dashboardzie
- Estimated Cost – wydatki na rzeczywiste requesty do providerów; cache hity są wykluczone.
- Saved Cost – ile kosztowałyby requesty obsłużone z cache’u, gdyby nie cache.
--- oznacza, że koszt jest nieznany, ponieważ cennik nie był dostępny – to nie to samo co $0.
Przeliczanie zapisanych kosztów
Przeliczanie ponownie oblicza zapisany koszt pasujących wierszy użycia według bieżącego cennika. Użyj go po zmianie nadpisania albo gdy cennik nie był dostępny w momencie wykonania requestu. Akcja jest domyślnie włączona (USAGE_PRICING_RECALCULATION_ENABLED); w widoku użycia wybierz Recalculate, a następnie wpisz recalculate, aby potwierdzić. Zakres przeliczenia obejmuje wybrany przedział dat, providera lub model oraz ścieżkę użytkownika.